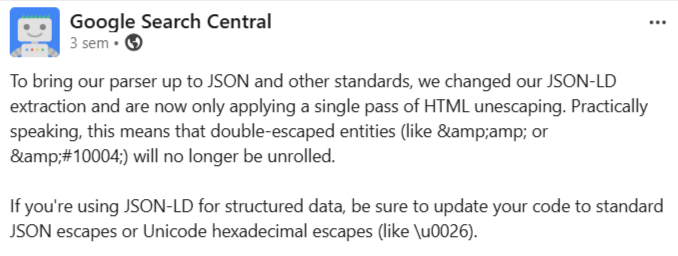
Le 20 août 2026, le compte LinkedIn de Google Search Central a annoncé un changement dans l’extraction du JSON-LD (le format de données structurées recommandé par Google, inséré dans un bloc script au sein du HTML) : le parseur n’applique plus qu’une seule passe de déséchappement HTML, là où il en enchaînait plusieurs. Les entités doublement échappées, du type & pour un simple &, ne sont plus corrigées.
Le point qui doit vous alerter n’est pas le changement lui-même : c’est que cette panne ne déclenche aucun signal.
Le JSON reste syntaxiquement valide, la Search Console ne remonte aucune erreur, le test des résultats enrichis affiche un verdict positif. Seule la valeur stockée par Google change, et elle change silencieusement.
Sur la page d’accueil de dell.com, la description extraite par l’outil de validation de Google contient aujourd’hui la chaîne littérale « services & support » à la place de l’esperluette attendue.
Un recensement publié fin août sur le Tranco top 10 000 chiffre l’ampleur réelle : 10 domaines sont affectés par le changement, mais 199 domaines publient des valeurs que Googlebot lit différemment de tout autre parseur, avant comme après.
L’audit à mener ne consiste donc pas à valider votre balisage. Il consiste à vérifier ce que Google en extrait.
Une seule passe de déséchappement : ce que Google a changé le 20 août
L’annonce tient en un paragraphe, publié sur LinkedIn et nulle part ailleurs : pour aligner son parseur sur JSON et les autres standards, Google n’applique plus que « a single pass of HTML unescaping ». Concrètement, une entité doublement échappée comme & ou ✔ n’est plus résolue en cascade jusqu’au caractère final. Google recommande de passer aux échappements JSON standard ou aux échappements Unicode hexadécimaux comme \u0026.
Gary Illyes, analyste chez Google, a complété en commentaire : l’échappement correct en JSON est « very, very well defined in RFC 8259 », section 7. Cette RFC 8259 (la spécification du format JSON) définit une liste fermée de séquences d’échappement par barre oblique inverse, à laquelle les entités HTML n’ont jamais appartenu.
Ryan Levering, ingénieur logiciel chez Google, a livré dans le même fil la justification technique absente de l’annonce : le double échappement est « relativement rare dans la vraie vie », ressemble généralement à un bug, et le double déséchappement causait des problèmes, en interne comme pour la parité avec les interprétations externes.
Dernier élément de contexte, vérifié le 2 septembre 2026 : le changelog officiel de la documentation Search Central, dont la dernière entrée date du 31 août, ne mentionne pas ce changement. Une modification du comportement d’extraction, annoncée uniquement par un post social, sans trace dans la documentation.
Un JSON valide, des valeurs corrompues : la panne que rien ne signale
Le mécanisme de la panne mérite d’être décomposé, parce qu’il explique pourquoi votre outillage ne la verra pas.
Quand un bloc script type="application/ld+json" contient &, deux systèmes d’échappement se superposent : l’encodage d’entités HTML (la représentation d’un caractère par une séquence comme &) et l’échappement de chaînes JSON. Jusqu’en août, le parseur de Google déroulait les entités jusqu’à obtenir un caractère simple. Il s’arrête désormais après une passe : & devient &, chaîne littérale, et s’arrête là.
Rien n’échoue dans ce parcours. Le JSON se parse. Le type se reconnaît. Les propriétés obligatoires sont présentes. Le test des résultats enrichis rend un verdict positif. Ce qui a changé, c’est la valeur de la propriété : un nom de produit, une description, une URL de recherche interne avec ses paramètres.
Les cas vérifiables existent déjà. Passées dans validator.schema.org, l’outil de validation de Google lui-même, les pages d’accueil de dell.com et d’investopedia.com ressortent avec des entités non résolues dans leurs propriétés description : elles étaient doublement échappées, et le changement d’août les casse visiblement. Côté français, la description de franceinfo.fr publie « livrées minute par minute » : après la passe unique, l’entité é reste en clair dans la valeur extraite, à la place du « é ».
Les sites les plus exposés sont ceux dont le JSON-LD sort d’une chaîne de templating : plugin de CMS, moteur de template avec échappement automatique, fonction d’encodage HTML appliquée deux fois. Une erreur de générateur se réplique alors sur des milliers de pages, sans qu’aucun rapport ne s’allume.
Comment tester que vos JSON-LD sont ok
L’outil validator.schema.org implémente déjà la passe unique : & ressort en &, & ressort en &, & ressort en &. Vous pouvez donc tester dès aujourd’hui le comportement post-changement contre l’outil de Google, sans attendre un passage de Googlebot.
La procédure de vérification ultime tient en trois étapes :
- Testez une URL représentative de chaque template générant du JSON-LD (fiche produit, article, page de liste), et lisez les valeurs extraites champ par champ, pas le verdict. Toute séquence
&,&#ou"visible dans une valeur extraite signale un problème. - Cherchez dans vos sources les motifs d’entités à l’intérieur des blocs
ld+json: une recherche sur&et&#dans le HTML rendu suffit à repérer le double échappement. - Corrigez le générateur, pas les pages : la sortie doit contenir du texte UTF-8 brut et les seuls échappements de la RFC 8259. Aucune entité HTML n’a sa place dans une chaîne JSON.
Un point de vigilance sur le correctif recommandé par Google : l’échappement \u0026 ne protège pas dans tous les cas, pour une raison démontrée au W3C et détaillée plus bas.
Le détail croustillant : l’implémentation 100% conforme, c’est zéro passe, pas une
L’annonce présente le changement comme une mise en conformité avec les standards. La lecture des spécifications raconte autre chose.
Le tokenizer du standard HTML (le composant qui découpe le flux de caractères en éléments) ne décode jamais les références de caractères à l’intérieur d’un élément script : l’état « script data » de la spécification ne comporte aucune clause pour le caractère &. Le nombre de passes conforme est donc zéro. La RFC 8259 ne mentionne pas les entités HTML, et JSON-LD 1.1 pas davantage. Une passe n’est pas plus spécifiée que deux ; Google est passé d’un comportement non standard à un autre comportement non standard, plus proche du compte exact.
Le correctif recommandé porte lui-même un défaut, exposé par Pierre-Antoine Champin, membre de l’équipe W3C, dans l’issue 498 du dépôt json-ld-syntax, et confirmé le 31 août par le recensement : la passe unique s’applique à la chaîne déjà décodée par JSON, pas aux octets sources. Une valeur écrite "\u0026lt;" est d’abord décodée par JSON en <, puis effondrée par la passe HTML en <. Conséquence mesurable : il n’existe aucune séquence d’octets que Google et un processeur conforme lisent tous deux comme la chaîne littérale <.
Un résultat négatif du recensement mérite d’être versé au crédit de Google : la structure JSON est parsée avant le déséchappement, une entité dans une valeur ne peut donc pas injecter de propriété. La passe restante n’est pas un vecteur d’attaque.
Le nouveau parseur n’est pas dans Googlebot, mais dans le WRS
Quatre jours après l’annonce, le 25 août, Gary Illyes a précisé sur Bluesky un point d’architecture que les titres de presse avaient écrasé : les crawlers de Google ne parsent pas le JSON, ils se contentent de télécharger. Le parsing intervient en aval, à l’indexation dans le cas de Search. Le changement d’août ne modifie donc pas Googlebot, mais le pipeline d’indexation.
La nuance a une portée pratique. Interrogé sur Merchant Center, Illyes a répondu que Google utilise une infrastructure partagée et qu’il est « très certain » que le Merchant Center s’appuie sur le même parseur, tout en précisant n’avoir jamais travaillé avec cette équipe. La documentation corrobore la logique : en novembre 2025, Google a migré sa documentation crawling vers un site dédié en expliquant que son infrastructure d’exploration sert de nombreux produits au-delà de Search, dont Google Shopping, News, Gemini et AdSense. Si votre balisage alimente des surfaces marchandes, considérez le changement comme applicable au-delà des résultats de recherche classiques.
Pourquoi ça compte, et ce que vous devez faire
Le risque n’est pas un effondrement de positions : ce changement ne touche pas au classement. Le risque, c’est une corruption de valeurs invisible et cumulative, sur les propriétés qui alimentent vos résultats enrichis, vos fiches marchandes et l’interprétation de vos pages par les systèmes qui lisent le web à la machine. Sur un site templatisé, une erreur de générateur égale des milliers de pages touchées, zéro alerte, et une dégradation qui ne se voit qu’en comparant la valeur publiée à la valeur extraite. Et si votre balisage fait partie des cas qui ne se lisent correctement que chez Google, tout consommateur tiers, crawlers d’IA compris, lit autre chose que ce que vous croyez publier.
La conduite à tenir, dans l’ordre :
- Inventoriez les templates qui génèrent du JSON-LD et cherchez
&amp;et&#dans leurs sorties rendues. - Soumettez une URL par template à validator.schema.org et lisez chaque valeur extraite ; l’outil applique déjà la passe unique.
- Corrigez le générateur : UTF-8 brut, échappements RFC 8259 uniquement, suppression de tout encodage HTML appliqué aux chaînes JSON.
- Traquez le cas
\u0026suivi de caractères formant une entité : il s’effondre en un caractère non voulu. - Étendez le contrôle aux flux marchands si vos produits transitent par Merchant Center, en comparant valeurs publiées et valeurs affichées.
Le geste central se résume en une phrase : cessez de demander à vos outils si votre balisage est valide, vérifiez ce que Google en a extrait.
Sources
- Annonce de Google Search Central sur LinkedIn, 20 août 2026
- Commentaire de Gary Illyes renvoyant vers la RFC 8259
- Post Bluesky de Gary Illyes sur le parsing du JSON, 25 août 2026
- RFC 8259, section 7 : l’échappement des chaînes JSON
- Recensement JSON-LD escaping conformance, Fabio Rovai, The Tesseract Academy
- Issue W3C json-ld-syntax n° 498, Pierre-Antoine Champin
- Changelog officiel de la documentation Google Search Central
- Validateur schema.org de Google
- JSON-LD Extraction For Googlebot Now Does One Pass Of HTML Unescaping, Search Engine Roundtable, 21 août 2026
- Google Says Google’s Crawlers Don’t Parse JSON, Search Engine Roundtable, 25 août 2026