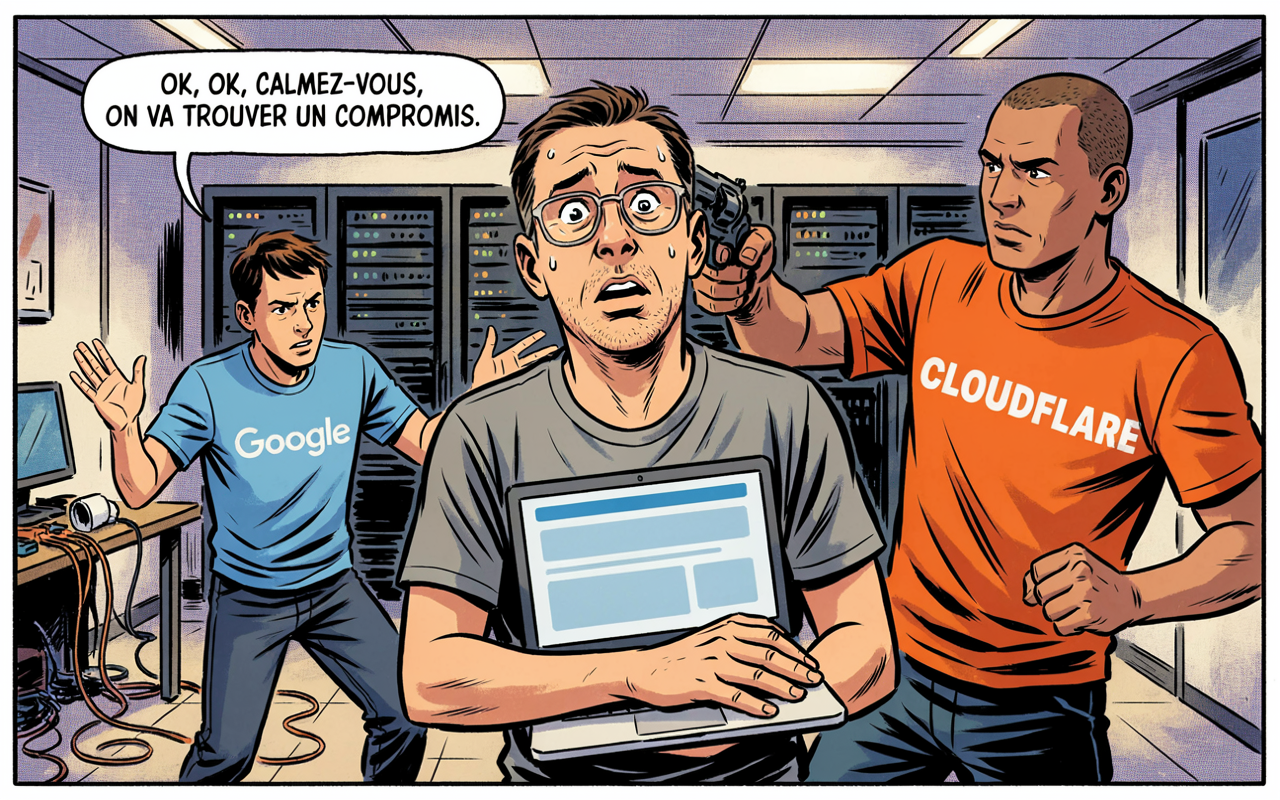
Le 1er juillet 2026, Cloudflare a posé un ultimatum : au 15 septembre, tout site qui avait choisi de cocher le paramètre de rejet des bots destinés à la collecte des données d’entraînement des modèles verrait aussi Googlebot, Bingbot et Applebot coupés.
Pourquoi ces bots ? Parce que leurs propriétaires font exprès de ne pas faire de différence entre le bot qui sert à l’exploration et l’indexation des sites pour le Search, et pour collecter des données d’entrainement des modèles. D’autres acteurs ont des bots différents, reconnaissable par des user agents différents. Mais pas Google, Bing, et Apple.
Du coup, cette décision pouvait ruiner le référencement des sites concernés, de manière silencieuse (qui lis les mails de Cloudflare chez vous ? Et qui aurait identifié immédiatement Cloudflare comme le responsable de l’arrêt de l’indexation ?).
Il faut insister dans quelle direction Cloudflare pointait son arme. Pas sur Google, qui perd peu à ne pas explorer quelques milliers de sites. Mais sur le trafic organique des clients de Cloudflare, pris en otage pour obtenir d’un tiers qu’il sépare ses robots.
Le 15 septembre, Cloudflare n’a pas mis sa menace à exécution : ils ont annoncé avoir signé des accords.
Google, Apple et Microsoft n’ont séparé aucun crawler, ni le 15 ni depuis. Ils ont signé des engagements écrits auprès de Cloudflare, obtenu un label maison baptisé Accountable, et l’ultimatum a été remplacé par un nouveau réglage, Disallow AI Training, qui laisse passer la recherche.
Tout ça pour ça !
Ce qui se jouait, et pourquoi personne ne pouvait en sortir gagnant
Le web a longtemps fonctionné sur un échange tacite : vous laissez entrer un robot, il vous renvoie des visiteurs. L’IA a cassé l’équilibre des termes de l’échange. La même requête qui indexe votre page nourrit un modèle qui répondra à votre place.
La difficulté tient à un détail d’architecture. Google, Apple et Microsoft explorent avec un robot à usages multiples : un seul agent, une seule requête, deux finalités. Refuser l’une revenait à refuser l’autre. Les chiffres publiés par Cloudflare disent l’ampleur du piège : moins de 1 % des sites de son réseau bloquent les robots de recherche, contre 17 % qui activent un blocage de l’entraînement. Autrement dit, un site sur six exprimait un refus qu’il ne pouvait pas appliquer sans sacrifier son référencement.
Cloudflare a passé un an à réclamer la séparation des crawlers. Il l’a demandée par exemple à la CMA britannique en février 2026, par écrit. La CMA a refusé en juin, jugeant la mesure disproportionnée.
Restait un levier : puisque les régulateurs n’allaient pas imposer la séparation à Google, Cloudflare allait rendre le statu quo insupportable pour les contrevenants en coupant le robinet chez les éditeurs.
La méthode était brutale, et le calendrier de dix semaines servait explicitement à laisser un délai pour négocier.
Ce que les éditeurs gagnent vraiment dans l’histoire
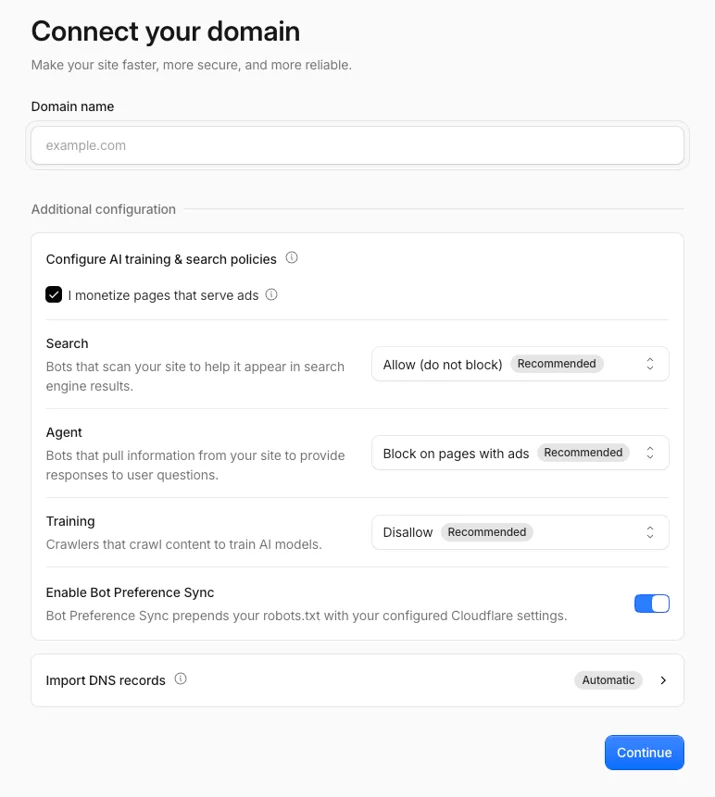
Un seul petit réglage dans Cloudflare permet désormais de rester exploré pour la recherche tout en refusant l’entraînement.
C’est beaucoup mieux que ce permet aujourd’hui un disallow dans un robots.txt, puisque bloquer Googlebot c’était tuer son référencement.
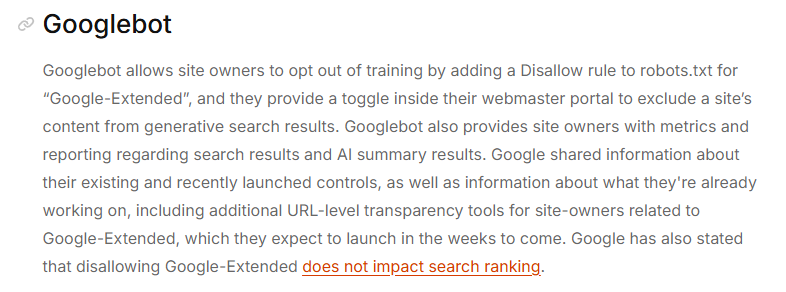
Cela fonctionne aujourd’hui sur Google et sur Apple, qui appliquent déjà des jetons d’exclusion respectés et confirment publiquement que ce refus n’affecte pas le classement.
Le second gain est une batterie d’engagements de la part des moteurs des recherches, dont certains sont nouveaux et clairement bienvenus.
Les quatre conditions du label Accountable exigent :
- un mécanisme d’exclusion de l’entraînement,
- un mécanisme d’exclusion des résumés IA,
- une visibilité au niveau de l’URL sur les pages rendues disponibles pour l’entraînement,
- et la garantie que ce refus n’affecte pas les résultats classiques.
Google a annoncé livrer ses outils de transparence par URL pour Google-Extended dans les semaines qui viennent.
Apple prépare les siens pour l’an prochain. C’est peu, mais c’est la première fois qu’un moteur s’engage sur une date à propos de ce qu’il fait de vos pages.
Les limites de la solution apportée par Cloudflare
La première est de nature technique.
Ce réglage crée une ligne automatiquement dans votre robots.txt. En créant une syntaxe « propriétaire » pas vraiment reconnue universellement. Cloudflare s’arroge le droit de faire du « Edge SEO » en modifiant votre robots.txt à la volée. Pourquoi pas, c’est pratique, cela fonctionne très bien, mais je ne suis pas sûr que tout le monde sera ravi de découvrir qu’on touche à leur robots.txt.
# BEGIN Cloudflare Bot Preference Sync

User-agent: GPTBot
User-agent: ClaudeBot
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

# END Cloudflare Bot Preference Sync

User-agent: *
Disallow: /wp-admin/

Sitemap: https://exemple.fr/sitemap_index.xml
Un exemple de la syntaxe ajoutée par Cloudflare dans le robots.txt
Le problème, c’est que vous avez peut être vos propres blocs qui autorisent l’entrainement sur certains dossiers et pas d’autres. Dans ce cas, le chemin le plus long l’emportera.
# BEGIN Cloudflare Bot Preference Sync
User-agent: Google-Extended
Disallow: /
# END Cloudflare Bot Preference Sync

User-agent: Google-Extended
Allow: /dossiers/
Dans l’exemple ci-dessus, les deux blocs « User-agent: Google-Extended » fusionneront virtuellement et votre directive Allow: /dossiers/ sera respectée.
Mais à condition que le fichier robots.txt de départ ait une syntaxe correcte..
Deuxième limite : l’implémentation chez Bing ne fonctionnera pas tout de suite. Microsoft ne sait pas encore lire une préférence de non-entraînement en robots.txt à l’échelle du domaine, et vise le début 2027. Pendant seize mois, un même réglage produira un effet réel sur Google et Apple et un effet nul sur Bing. Les alternatives existent, balise NOARCHIVE ou outil de suppression d’URL, mais elles se règlent page par page, pas d’une case à cocher. Pour tout éditeur qui travaille Copilot ou les réponses web de ChatGPT, l’écart n’est pas théorique.
La troisième est la plus lourde. L’entraînement n’est pas ce qui vous coûte du trafic. Ce sont les résumés génératifs.
Refuser l’entraînement ne vous retire pas des AI Overviews, qui puisent dans l’index de recherche. Les données citées par Cloudflare sont sans ambiguïté : d’après le Pew Research Center, plus de la moitié des internautes lisent les résumés en tête de résultats, et ceux-là sont plus de 40 % plus susceptibles de terminer leur recherche sans cliquer.
L’accord du 15 septembre règle le problème de propriété intellectuelle. Il laisse intact le problème d’audience.
Le piège opérationnel, qui a changé de sens
Il faut maintenant rectifier une consigne que toute la profession répète depuis deux ans.
Jusqu’au 15 septembre, le réglage Block ne s’appliquait pas aux robots mixtes, précisément parce que les couper aurait détruit la découvrabilité.
Maintenant qu’un réglage intermédiaire existe, Block s’applique à tous les robots d’entraînement, robots mixtes compris.
Sélectionner Block sur la catégorie Training coupe donc Applebot, Bingbot et Googlebot, recherche incluse.
Le risque s’est inversé. Avant, l’exposition venait d’un vieil interrupteur oublié. Maintenant, elle vient du geste délibéré d’un intervenant qui ouvre le tableau de bord, veut protéger un site et clique sur l’option qui porte le nom le plus rassurant.
Toutes les recommandations d’agence qui recommandaient de cocher Block AI bots sont devenues obsolètes et dangereuses.
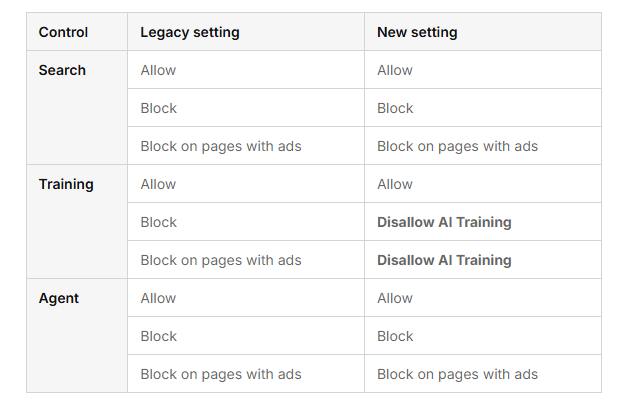
Sur les comptes existants, Cloudflare migre automatiquement et épargne les configurations : un ancien blocage de l’entraînement, granulaire ou hérité, devient Disallow AI Training. Le déploiement s’étale sur la semaine, et le seul indicateur fiable de son achèvement est la disparition de l’interrupteur Block AI Bots du tableau de bord. Les éditeurs qui subissaient des 403 sur Googlebot depuis début juillet, comme celui de home-barista.com dont le signalement est resté sans réponse, n’auront jamais eu d’explication. Ils auront eu un correctif silencieux.
Qui a écrit la règle, et pourquoi c’est le vrai sujet
Posez la question autrement : en 2026, qui définit ce qu’est une exploration IA responsable ?
Pas le régulateur. La CMA a instruit le dossier pendant un an, avec consultation publique et contributions contradictoires, avant d’écarter la séparation des crawlers. Ses obligations n’entrent en vigueur que le 3 décembre 2026. Pas non plus un organisme de normalisation : le groupe de travail de l’IETF sur les préférences d’usage IA n’a pas abouti, Cloudflare le reconnaît lui-même en expliquant qu’il ne propose aucun réglage déclaratif pour les agents faute de directive établie.
C’est donc une entreprise privée qui a rédigé les quatre critères, décerné le label à trois candidats, et qui en publiera le suivi sur son propre outil de mesure. La même entreprise vend le contrôle d’accès, la synchronisation des préférences et une passerelle de monétisation du crawl. Le certificateur est le fournisseur, et le juge de la conformité est la partie qui avait porté plainte.
La leçon dérange, mais elle est nette. En onze semaines, en menaçant le trafic de ses propres clients, un opérateur propriétaire de tuyaux du web a obtenu de Google et de Microsoft des engagements datés qu’une procédure réglementaire d’un an n’avait pas produits. Ce constat vaut précédent, et il sera réutilisé.
Le prochain levier est déjà annoncé
Cloudflare ne s’en cache pas : les résumés IA sont la cible suivante, et l’objectif affiché est de permettre, d’ici au début de l’année prochaine, de régler chez lui non pas l’inclusion dans un résumé, mais la part de contenu qui peut y être reprise.
Autrement dit, la seule limite qui compte vraiment pour l’audience va être négociée par la même méthode, dans le même cadre privé, avec le même arbitre. L’exclusion des résumés figure déjà parmi les quatre conditions du label, ce qui signifie que le rapport de force est en place avant même l’ouverture de la discussion.
Pour un éditeur français, deux conséquences pratiques en découlent. La première est qu’il faudra décider, dans les mois qui viennent, si l’on délègue à un prestataire d’infrastructure l’arbitrage de sa relation avec trois moteurs, ou si l’on traite avec chacun séparément. La seconde est que les organisations professionnelles, syndicats de presse et fédérations métier, sont totalement absentes de cette table. Le standard de fait se construit sans elles, en anglais, entre quatre entreprises américaines.
Ce qu’il faut faire cette semaine, et ce qu’il faut surveiller
Vous utilisez Cloudflare ?
Rien d’urgent ne menace votre indexation : la migration protège les configurations existantes. L’urgence est ailleurs, dans les décisions qui seront prises sur la base d’anciennes consignes.
- Réécrivez vos procédures internes avant tout autre geste. Celles qui disent « cocher Block AI bots » enverront vos clients dans le mur dès la première application.
- Attendez la fin de migration zone par zone, repérable à la disparition de l’interrupteur, puis vérifiez que l’état des trois contrôles correspond bien à votre intention.
- Inspectez le robots.txt après le passage de la synchronisation de préférences, pour savoir quelle déclaration a été écrite en votre nom.
- Traitez Bing à part : la situation intermédiaire durera jusqu’en 2027.
Bibliographie
- Have it both ways: stay discoverable in search while disallowing AI training, blog Cloudflare, Bryan Becker, 15 septembre 2026 (source primaire)
- Your site, your rules: new AI traffic options for all customers, blog Cloudflare, 1er juillet 2026, l’ultimatum initial (source primaire)
- Say it once: introducing Bot Preference Sync, blog Cloudflare (source primaire)
- Réponse de Cloudflare à la consultation de la CMA sur le Publisher Conduct Requirement, 25 février 2026 (source primaire)
- Décision finale de la CMA sur les contrôles éditeurs, lecture de la Publishers Association
- Google common crawlers, dont Google-Extended (source primaire)
- Announcing new options for webmasters to control usage of their content in Bing Chat, blog Bing Webmaster (source primaire)
- Google users are less likely to click on links when an AI summary appears, Pew Research Center
- Groupe de travail ai-prefs de l’IETF (source primaire)
- Googlebot blocked by « Block AI training crawlers » before September 15, communauté Cloudflare, 22 août 2026