Le 8 octobre 2026, Google a ajouté au site Search Central une page consacrée au UGC Fresh Data Program.
Le principe : des plateformes de contenus générés par les utilisateurs, sélectionnées sur dossier, peuvent pousser directement leurs publications et leurs compteurs d’engagement vers Google, sans attendre le passage de Googlebot.
Google précise que ce canal est indépendant de l’Indexing API et du crawl organique. Pour tous les autres sites, la règle reste la même depuis 2018 : on attend le robot, et l’API d’indexation est réservée aux offres d’emploi et aux vidéos en direct.
Google vient d’inventer l’indexation à deux vitesses. Mais l’indexation « TGV » est réservée à quelques plateformes élues.
Ce que Google a réellement publié
Qui sont les heureux élus ?
La page est courte et ne nomme aucune plateforme. Donc rien d’officiel. On pense évidemment à Reddit, mais il y’en a d’autres.
Trois conditions mentionnées dans l’annonce de la fonctionnalité méritent d’être signalées :
- Le mot « trending ». Google décrit un pipeline spécialisé réservé aux contenus UGC tendance. L’objectif n’est donc pas d’indexer davantage de pages de forum, mais d’indexer plus vite celles qui montrent de la traction.
- Le rangement dans un « Early Adopters Program ». Dans le menu de Search Central, la page figure sous cette rubrique, à côté du suivi de colis (package tracking). C’est un dispositif expérimental, à accès sélectif.
- L’absence de garantie. Google écrit que le programme ne garantit pas l’apparition des contenus dans Search, et ne précise ni les pays concernés, ni les fonctionnalités alimentées. La formule retenue, « various features on Search », ne mentionne ni AI Overviews, ni AI Mode, ni Discover.
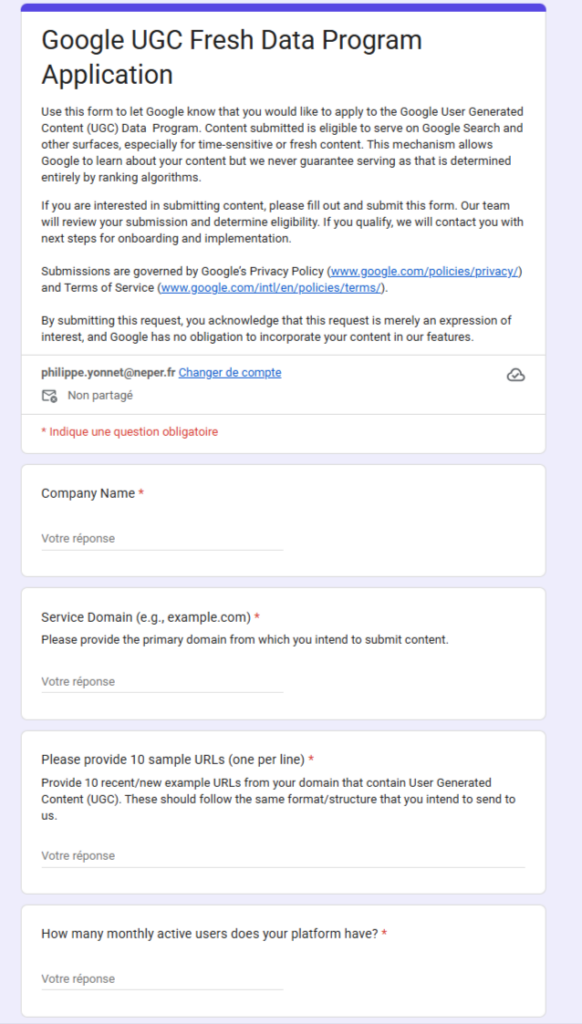
Le UGC, ou user-generated content, est défini par Google comme tout contenu hébergé par une plateforme mais créé entièrement par des utilisateurs indépendants. La candidature passe par un formulaire, et Google annonce une réponse sous 6 à 8 semaines, sans engagement d’acceptation. Les spécifications techniques ne sont transmises qu’aux plateformes retenues.
Les critères d’entrée : un club fermé par construction
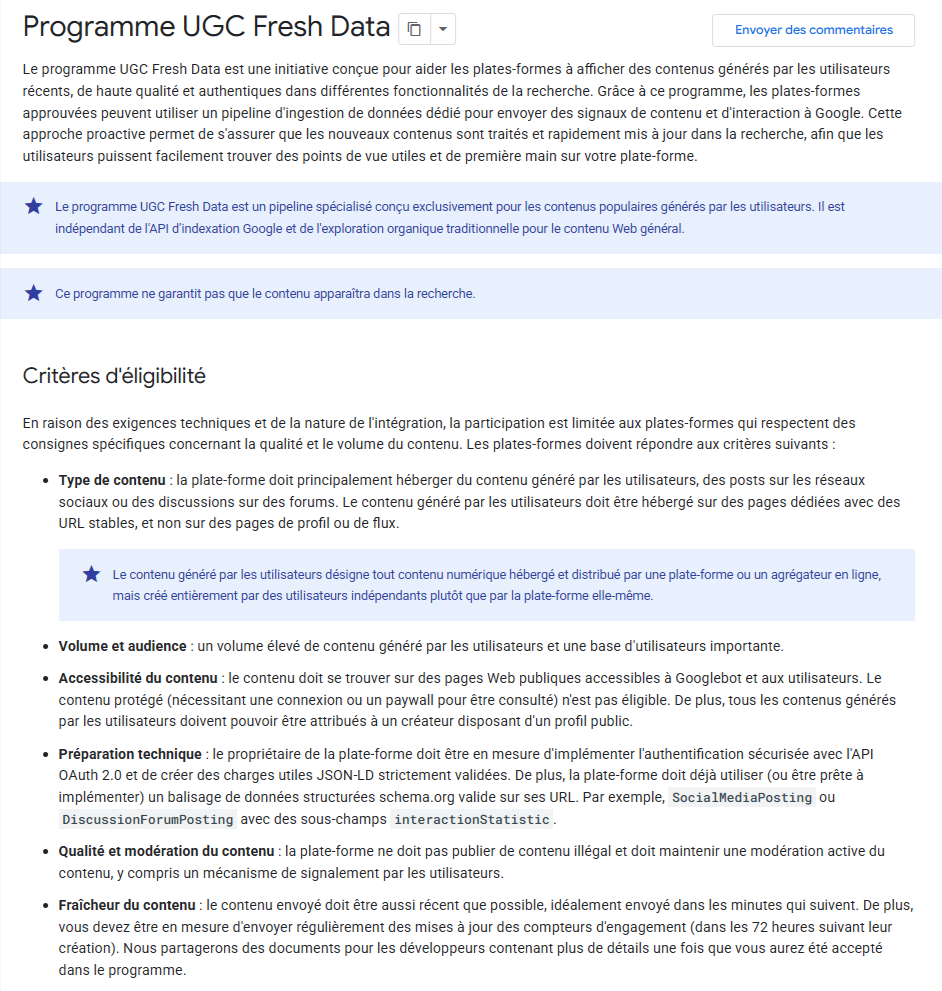
Les six critères d’éligibilité ne sont pas des recommandations techniques. Ils dessinent le profil des élus.
| Critère | Exigence |
|---|---|
| Nature du contenu | Majoritairement UGC, posts sociaux ou discussions de forum, sur des pages à URL stable (pas les pages de profil ou de fil) |
| Taille | Volume élevé de contenus et base d’utilisateurs significative |
| Accès | Pages publiques, accessibles à Googlebot ; tout contenu derrière login ou paywall est exclu ; chaque contenu doit être rattaché à un créateur au profil public |
| Technique | Authentification OAuth 2.0, payloads JSON-LD strictement validés, balisage schema.org sur les pages |
| Modération | Aucun contenu illégal, modération active et mécanisme de signalement |
| Fraîcheur | Envoi idéalement en quelques minutes, mise à jour des compteurs d’engagement pendant 72 heures |
Un forum ouvert comme Reddit coche toutes les cases. Les plateformes qui conditionnent la lecture à une connexion, comme LinkedIn ou une partie de Facebook et d’Instagram, tombent dehors tant qu’elles maintiennent leur mur.
L’Indexing API, la porte que Google a laissé ouverte et l’a refermée
Pour mesurer ce qui change, il faut revenir à l’Indexing API, lancée par Google en 2018. Elle permet à un site de notifier Google qu’une URL vient d’être créée, modifiée ou supprimée, ce qui déclenche un crawl prioritaire. Sa page de référence précise qu’elle ne peut servir qu’aux pages portant un balisage JobPosting, ou un BroadcastEvent intégré à un VideoObject, c’est-à-dire aux offres d’emploi et aux vidéos en direct.
Pendant des années, une partie de la profession a contourné cette limite en soumettant toutes sortes d’URL par l’API, parfois avec plusieurs comptes pour multiplier les quotas. Google a répondu par la fermeté. À l’automne 2024, cette page a gagné un avertissement : toutes les soumissions passent par une détection de spam, et l’usage de comptes multiples pour dépasser les quotas peut entraîner la révocation de l’accès.
Google ne contredit pas sa doctrine pour autant. Il ne retire rien aux sites qui attendent Googlebot. Mais il assume qu’un contenu publié par un internaute sur une grande plateforme mérite un circuit que le contenu d’un journaliste professionnel n’obtient pas.
Le précédent Reddit : ce que Google payait, il le reçoit
Ce dispositif rappelle un accord précis. En février 2024, Google a obtenu l’accès à la Data API de Reddit, pour un montant estimé par la presse à 60 millions de dollars par an, jamais confirmé officiellement. Rajan Patel, vice-président chez Google, expliquait alors que cette API fournissait un contenu structuré et en temps réel, avec des signaux enrichis pour mieux comprendre, afficher et entraîner ses modèles sur les données de Reddit. Google précisait que l’accord ne changeait rien à son usage du contenu public crawlable.
Depuis, la relation s’est tendue. En septembre 2025, Bloomberg a rapporté que Reddit voulait renégocier, en réclamant une tarification dynamique qui augmenterait à mesure que ses discussions deviennent centrales dans les réponses des IA, et des renvois de trafic vers ses communautés. À notre connaissance, aucun nouvel accord n’a été rendu public.
Le UGC Fresh Data Program inverse le modèle de 2024 :
- en 2024, Google allait chercher les données chez Reddit, via l’API de Reddit, et payait ;
- en 2026, les plateformes envoient leurs données vers un pipeline de Google, au format fixé par Google, et la page de Google ne mentionne aucune contrepartie financière.
Rien ne permet d’affirmer que le programme vise à affaiblir la position de Reddit dans sa négociation. En revanche, Google dispose désormais d’une procédure standard pour obtenir de n’importe quelle plateforme éligible ce qu’il a dû acheter à Reddit.
Les compteurs d’engagement, un signal déclaré par la plateforme
Le critère le plus lourd de conséquences tient en une ligne : les plateformes doivent pouvoir mettre à jour régulièrement les compteurs d’engagement pendant 72 heures après la création d’un contenu. La doc cite comme exemples les types schema.org SocialMediaPosting et DiscussionForumPosting, avec le sous-champ interactionStatistic.
Ce champ sert à déclarer, pour un contenu, le nombre d’interactions d’un type donné : votes, likes, commentaires, partages. Sur une page classique, Google peut le lire lors du crawl et le confronter à ce qu’il voit. Dans le pipeline, la plateforme transmet elle-même ces chiffres, en continu, pendant la phase où un contenu décolle ou non.
Deux conséquences pratiques en découlent.
- La fraîcheur change de nature. Ce n’est plus seulement la date de publication qui compte, mais la courbe d’engagement des premières heures. C’est précisément le signal qui permet de distinguer un contenu tendance d’un contenu ordinaire, d’où le mot « trending ».
- La fiabilité repose sur la plateforme. L’exigence de modération active et de mécanisme de signalement prend ici son sens : Google délègue une partie du contrôle qualité en amont. Les faux comptes et les votes achetés deviennent un problème de la plateforme avant d’être celui de Google.
Google n’explique pas comment ces compteurs pèsent dans le classement. Toute affirmation sur leur poids exact relèverait de la spéculation.
A quoi cela va servir ?
Les SERPs vont elles être envahies de résultats d’outils sociaux ? Pas sûr. Google n’est pas très transparent sur la réutilisation des données. Ce qui est clair, c’est qu’un tel système serait très utile pour détecter les sujets tendance à pousser dans Google Discover, et à détecter quels résultats servir sur des requêtes de type QDF (Query Deserves Freshness) alors que l’intérêt pour la requête est encore un signal faible.
Bref, on verra à l’usage, mais il y’a de grandes chances que certains seront déçus voire choqués de l’intérêt véritable de servir ces données sur un plateau à Google. Même s’ils ont été avertis :
« Ce programme ne garantit pas que le contenu apparaîtra dans la recherche. »
Bibliographie
- UGC Fresh Data Program, Google Search Central
- Documentation updates, Google Search Central
- Indexing API, Google Search Central
- Discussion forum structured data, Google Search Central
- Analyze social and video platform content in Search Console, Google Search Central
- Add a Search profile badge to your website, Google Search Central
- Google Reveals The UGC Fresh Data Program, Search Engine Roundtable
- Google Adds Spam Warning To Indexing API Documentation, Search Engine Journal
- Reddit and Google strike $60m annual data-sharing deal, Mobile Marketing
- Reddit pushes Google for more from their AI deal, Techloy