Ce n’est pas une règle absolue, mais quand Google change ses guidelines, c’est souvent parce que les équipes « qualité de recherche » ont envie de sévir dans la foulée. En clair, cela annonce que la prochaine version de l’algorithme risque de frapper ceux qui, justement, ne suivent pas ces guidelines.
Il y’a des exceptions : parfois, on voit bien que certaines consignes sont ajoutées après coup, parce que quelqu’un s’est aperçu que personne n’avait communiqué sur un changement de règles.
Or là, début octobre, c’est trois changements sur les guidelines qui ont été apportés.
Trois ajouts en deux jours, un seul annoncé
Le 1er octobre, le guide sur l’usage du contenu généré par IA a été mis à jour, « avec des informations tirées des guidelines des quality raters ». Google justifie la modification par la volonté d’aligner sa documentation sur les présentations faites lors de ses événements pour développeurs, les Search Central Live.
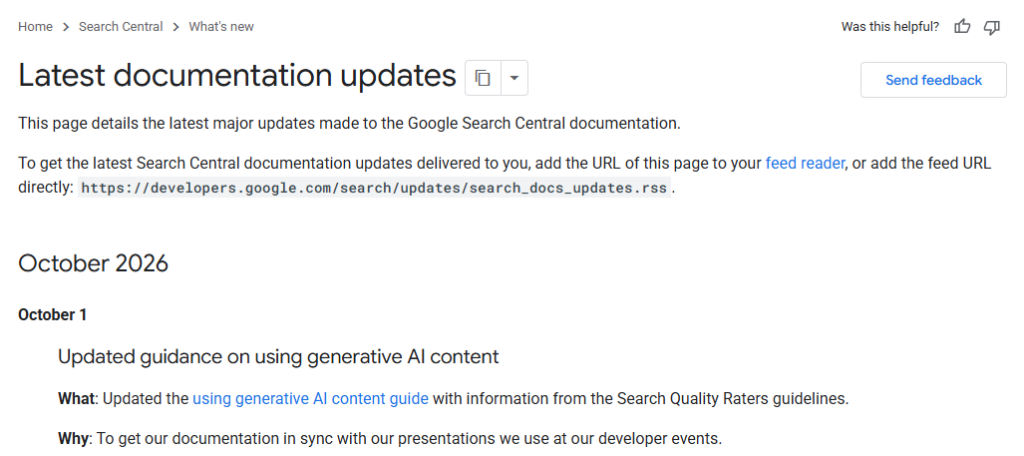
Le même jour, la page sur le « helpful content » a été modifiée.
Qu’est-ce qui a été ajouté / modifié :
- sur la page IA générative, est apparue une obligation de vérification manuelle des contenus générés avant publication, étendue aux métadonnées ;
- sur la page « helpful content », une définition du main content et la liste des quatre attributs que les raters évaluent ;
- sur la même page, un paragraphe contre la fausse paternité des contenus.
Les deux pages emploient le même mot, « critical », pour qualifier les deux premiers sujets. Il faut noter que ce terme est rarement utilisé dans les guidelines chez Google.
Côté guide des quality raters, rien de nouveau
Tout ce que Google vient de publier figure déjà dans ce manuel :
- la section 3.2 des QRG fonde la qualité du main content sur l’effort, l’originalité et le talent ou la compétence mis dans sa création ;
- la mise à jour de janvier 2025 a créé la section 4.6.5 sur le scaled content abuse (production massive de contenus sans effort ni relecture) et la section 4.6.6 sur le main content produit avec peu d’effort, peu d’originalité et peu de valeur ajoutée ;
- la section 4.5.3, consacrée aux pages trompeuses, cite déjà parmi ses exemples les contenus générés par IA signés de faux profils d’auteurs, construits avec des images générées ou des biographies inventées.
La page sur l’IA générative renvoie quant à elle aux sections 4.6.5 et 4.6.6.
La dernière édition à jour reste celle du 11 septembre 2025.
L’élément nouveau ici, c’est le transfert vers les guidelines pour les éditeurs de sujets pointés du doigt pour les quality raters : ce que Google demandait à ses évaluateurs de repérer, il demande désormais aux éditeurs de l’éviter.
Attention à la génération automatisée de pages
Attention : Google n’annonce aucune nouvelle sanction et ne modifie pas ses spam policies. Le paragraphe figure dans des pages de recommandations.
Le paragraphe sur la fausse paternité se termine par une phrase qui va plus loin que les QRG.
Toute forme de tromperie, écrit Google, rend une page « untrustworthy to both users and our automated quality systems » et constitue un signal de faible qualité.
C’est la première fois que la documentation publique relie explicitement les faux auteurs aux systèmes automatisés de qualité, et non plus seulement au jugement des quality raters.
Le second changement réel concerne les métadonnées.
L’ancienne version de la page IA générative indiquait que l’exigence d’exactitude « inclut » les éléments <title>, les meta descriptions, les données structurées et les textes alternatifs des images. La nouvelle écrit que la relecture s’y applique aussi, juste après avoir posé qu’« It is critical to manually factcheck and review all AI-generated content ». Les métadonnées passent d’une exigence générale de qualité au périmètre d’une vérification humaine avant publication.
Les sites concernés au premier chef sont ceux qui génèrent par template ou par modèle :
- les balises title de milliers de fiches produits ;
- les meta descriptions automatiques ;
- les textes alternatifs produits par un modèle de vision ;
- les données structurées remplies depuis un flux.
Pseudonymes, prête-noms, signature IA : comment interpréter les consignes
Google cible clairement la fabrication de profils destinés à faire croire qu’un expert humain a écrit le contenu.
La ligne de partage qui se dégage du texte porte sur la tromperie, pas sur l’outil. Un contenu assisté par IA, signé par une personne qui l’a réellement relu et qui en répond, n’entre pas dans ce qui est ciblé dans le texte.
Une biographie d’expert inventée pour habiller un texte généré par IA, c’est de la tromperie.
Quid des pseudonymes d’auteur : ce n’est pas clairement dit, mais ce n’est pas réellement une tromperie. Les « prête noms » par contre, cela peut rentrer dedans : attribuer la paternité d’un texte fait 100% par une IA à un vrai « journaliste », c’est franchir la ligne jaune.
Un bon main content selon Google : effort, originalité, talent ou compétence, exactitude
Google définit désormais publiquement le main content comme toute partie de la page qui contribue directement à son objectif. La liste compte cinq catégories :
- le texte principal et les médias (images, audio, vidéo) ;
- les fonctionnalités interactives : calculateurs, outils, jeux, moteur de recherche interne ;
- les contributions des utilisateurs (forums, avis, commentaires) quand elles servent l’objectif de la page ;
- les sections en onglets ou dépliables, comme les caractéristiques d’un produit ou les avis clients ;
- les titres et intertitres visibles.
Pour les raters, ce contenu s’évalue sur quatre attributs : effort, originalité, talent ou compétence, exactitude. Voici ce qui est repris dans la doc sur le « Helpful content »
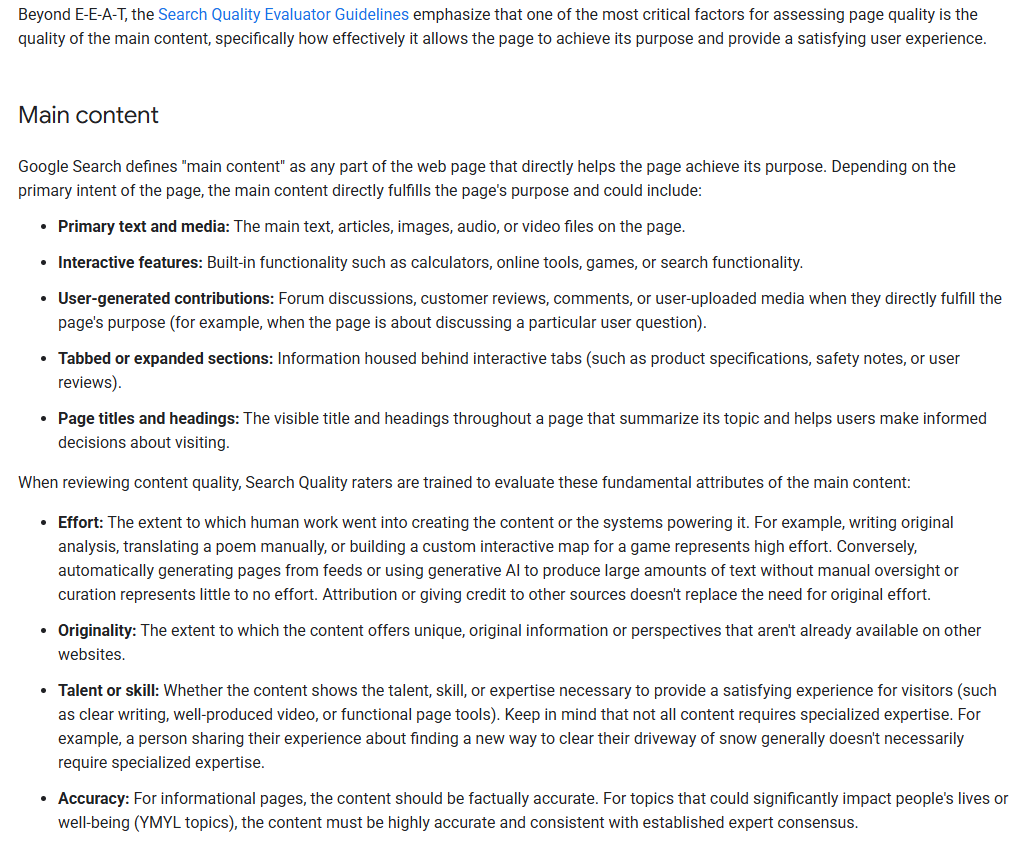
Plusieurs précisions intéressent directement les praticiens. L’effort peut se loger dans les systèmes : Google cite la construction d’une carte interactive sur mesure comme un exemple d’effort élevé. Un site programmatique bien conçu n’est donc pas disqualifié par principe, alors qu’une génération de pages à partir de flux, sans supervision, est explicitement citée comme effort nul.
Citer ses sources, ensuite, ne remplace pas un apport original : la doc l’écrit en toutes lettres, ce qui vise les agrégateurs et la curation sans valeur ajoutée.
Enfin, pour les sujets YMYL (Your Money or Your Life, les thèmes qui touchent à la santé, aux finances ou à la sécurité des personnes), l’exactitude doit être conforme au consensus d’experts établi. La formulation existait dans les QRG ; elle figure désormais dans la documentation adressée aux éditeurs.
Bon, que faire par rapport à ces nouvelles consignes ?
Relisez bien ces nouvelles formulations : si vous pensez être concerné, agissez vite, mais les signaux ciblés par une prochaine Core Update risquent d’avoir été évalués avant que Google prenne connaissance de vos changements… Mais vous aurez plus de chances de remonter vite lors de la prochaine mise à jour.
Ce qu’il faut contrôler, par ordre de priorité :
- Auditez vos signatures. Chaque auteur affiché doit être une personne réelle, identifiable et vérifiable. Supprimez les portraits générés et les biographies sans fondement.
- Cartographiez chaque point où un modèle écrit quelque chose qui part en ligne, du corps de texte aux balises title, meta descriptions, textes alternatifs et données structurées, et relisez ou faites relire le résultat par un humain (suffisamment compétent pour qu’il arrive à détecter une erreur).
- Indiquez qu’une IA a été utilisée là où le lecteur peut se poser la question. C’est ce que demande la section « How », et c’est la meilleure protection contre le soupçon de tromperie.
- Évaluez vos gabarits programmatiques au regard du critère d’effort. Un outil ou une base de données construits sur mesure se défendent ; un flux repris tel quel ne se défend pas.
Et préparez vous à l’impact…