
Le 17 novembre 2026, Google a publié dans la section crawling infrastructure de Google for Developers une page intitulée « Allow Google-Agent traffic ».
Elle ne s’adresse pas vraiment aux SEO mais aux équipes qui administrent un CDN, un WAF (web application firewall) ou un service anti-bots.
La consigne tient en une ligne : pour les requêtes vérifiées de Google-Agent, skip bot challenges, autrement dit pas de CAPTCHA ni de défi JavaScript. Le texte liste ensuite les six raisons habituelles pour lesquelles un agent reste bloqué même après qu’une règle d’autorisation a été créée. Google publie cette page deux mois après que Cloudflare a commencé à bloquer par défaut la catégorie « Agent » sur les pages avec publicité des nouveaux domaines. Pour un site marchand, la conséquence est simple : l’accès de cet agent se règle désormais dans le pare-feu, et robots.txt n’y change rien.
Un mandataire, pas un crawler
Google a ajouté Google-Agent à sa liste des user-triggered fetchers le 20 mars 2026. La définition n’a pas changé depuis : le nom désigne les agents hébergés sur l’infrastructure de Google qui naviguent et agissent sur le web à la demande d’un utilisateur. Le user-agent contient la chaîne compatible; Google-Agent, et les requêtes partent d’adresses IP publiées dans un fichier dédié, user-triggered-agents.json, distinct de ceux de Googlebot et des autres fetchers.
Ce classement a deux conséquences.
- robots.txt ne s’applique pas. Google écrit que ces fetchers « generally ignore robots.txt rules », parce que la requête vient d’un utilisateur. Une ligne
User-agent: Google-Agentsuivie deDisallow: /reste sans effet. - Google-Extended n’a rien à faire ici. Ce token encadre l’usage des pages explorées par Googlebot pour l’entraînement et le grounding de Gemini. Google-Agent, lui, n’alimente aucun index : il exécute la tâche d’une personne, comme le ferait son navigateur.
Gary Illyes, de l’équipe Search de Google, a défendu cette position dans un podcast le 28 octobre, selon PPC Land : un fetcher qui agit pour un seul utilisateur n’a, d’après lui, aucune bonne raison d’obéir à robots.txt.
La question de ce que devient l’information récupérée se pose donc entre l’utilisateur et Google, dans les conditions du produit Gemini qu’il utilise, et non entre le site et Google. Pour l’éditeur, Google-Agent ressemble davantage à un client équipé d’un navigateur un peu particulier qu’à un robot d’exploration.
Quels produits envoient ces requêtes
Google ne le dit pas. En mars, la fiche citait Project Mariner en exemple. Le prototype a été fermé le 4 mai 2026 et la fiche actuelle, mise à jour le 19 août, ne nomme plus aucun produit.
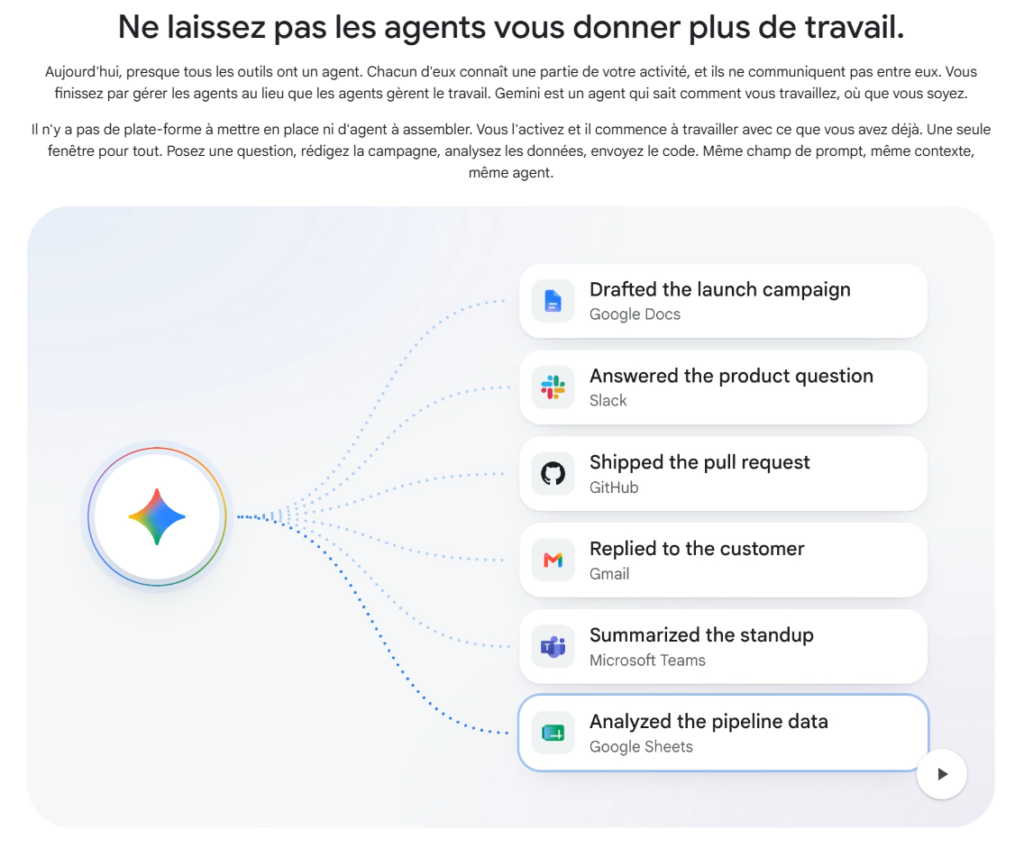
Les produits annoncés depuis permettent de restreindre la liste. La définition retenue par Google, des agents hébergés sur son infrastructure, correspond à deux d’entre eux.
- Gemini Spark, présenté à Google I/O le 19 mai 2026. C’est un agent personnel qui tourne en continu sur des machines virtuelles dédiées dans Google Cloud et qui navigue sur le web pendant que l’ordinateur de l’utilisateur est éteint. Il a été ouvert aux abonnés AI Ultra américains fin mai, puis aux abonnés AI Pro américains le 23 juillet.
- L’agent Gemini pour les entreprises, annoncé le 8 octobre 2026 à Gemini at Work. Il s’exécute lui aussi dans le cloud de Google, pour le compte d’employés.
Pourquoi cette page sort maintenant
Les agents se font bloquer, et la liste de dépannage de Google montre qu’il le sait et que cela commence à lui poser des problèmes.
Le 1er juillet 2026, Cloudflare a réparti le trafic IA en trois catégories : Search, Training et Agent. La catégorie Agent couvre tout comportement automatisé qui agit en temps réel pour le compte d’une personne. Cloudflare y range nommément les agents qui pilotent un navigateur, avec l’exemple de « Gemini ou Claude » aux commandes de Chrome. Depuis le 15 septembre, les nouveaux domaines financés par la publicité démarrent avec une configuration par défaut qui bloque les agents sur les pages affichant des publicités. Le même jour, Cloudflare a renoncé à son projet de bloquer Googlebot sur les sites refusant l’entraînement. Le blocage par défaut des agents, lui, est resté.
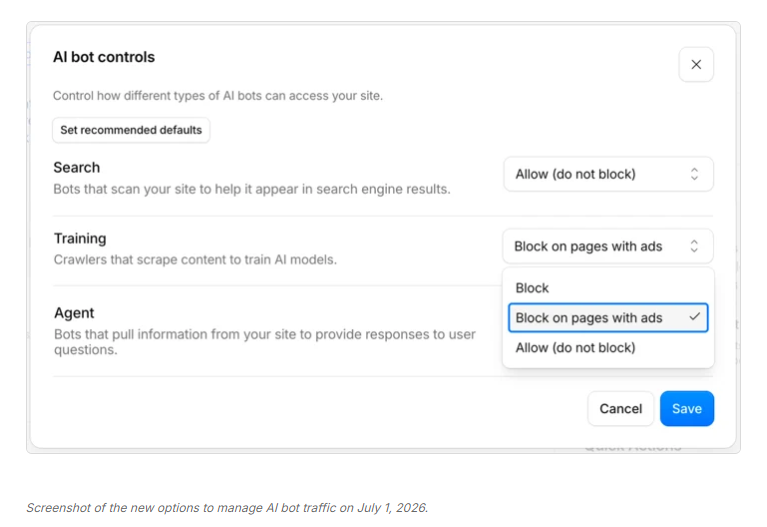
Par défaut, les agents, dont les agents de Gemini, sont bloqués par Cloudflare
Le raisonnement de Cloudflare se défend : un agent ne voit pas les publicités, et un site financé par l’affichage n’a aucune raison commerciale de le servir. Il vaut pour un média. Il ne vaut plus pour un site dont le revenu vient d’une transaction.
Les premières mesures vont dans le même sens. Selon des données de la société Blend reprises par PPC Land, les protections anti-bots bloquaient son agent d’achat chez 29 distributeurs sur 200 testés au Royaume-Uni et aux États-Unis. Le chiffre vient d’un éditeur d’agent qui a intérêt à démontrer le problème, et il ne porte pas sur Google-Agent. Il donne cependant un ordre de grandeur.
Les six pièges que Google a listés
La section de dépannage se lit comme une liste d’incidents remontés à Google. Chacun correspond à une configuration courante.
- Priorité des règles. La règle d’autorisation doit s’évaluer avant les blocages larges : ASN de data centers et de clouds, règles anti-bots gérées, politiques par catégorie « AI agents ». Un blocage d’ASN Google Cloud placé plus haut rend l’exception inopérante.
- Défis interactifs. L’exemption doit couvrir les CAPTCHA et les défis JavaScript, y compris les widgets déclenchés sur la recherche interne ou à la soumission d’un formulaire.
- Le parcours entier. La page d’accueil ne suffit pas. Google cite la recherche sur le site, les filtres, les fiches détaillées, l’ajout au panier, la réservation, et les appels XHR, GraphQL ou
api.*qui les servent. - Rate limiting par IP. Les requêtes de plusieurs utilisateurs partent du même pool de sortie. Selon PPC Land, le fichier
user-triggered-agents.jsoncomptait 20 préfixes le 16 novembre (12 IPv4, 8 IPv6). Un quota par adresse calibré pour un humain sanctionne tous les utilisateurs de l’agent en même temps. - Plages IP à jour. Les règles doivent suivre le fichier, que Google régénère chaque jour.
- Proxys et load balancers. Ils doivent transmettre l’IP d’origine, le user-agent et, pour les requêtes signées, les en-têtes
Signature,Signature-InputetSignature-Agent.
Les points 3 et 4 décrivent un tunnel de conversion. Google ne parle pas d’indexation : il décrit un agent qui remplit un panier et se heurte à un pare-feu.
Vérifier l’identité de l’agent avant d’autoriser
Autoriser Google-Agent ne veut pas dire laisser passer tout ce qui s’annonce comme tel. Selon PPC Land, Gary Illyes rappelait dans le même podcast que falsifier le user-agent de Googlebot prend une trentaine de secondes. Celui de Google-Agent ne résiste pas mieux.
La page du 17 novembre donne la règle à appliquer quand le fournisseur ne vérifie pas lui-même. Elle comporte trois conditions, cumulatives quand la troisième est disponible :
- le user-agent contient
Google-Agent; - l’adresse IP figure dans
user-triggered-agents.json; - si la requête est signée, les en-têtes
SignatureetSignature-Inputse vérifient pourSignature-Agent: g="https://agent.bot.goog".
Une requête qui remplit la première condition sans la deuxième doit être traitée comme n’importe quel robot inconnu. Les scrapers qui empruntent le nom d’un agent connu pour franchir les filtres échouent précisément à ce contrôle.
Mais le hic, c’est l’endroit où la règle s’applique. Si un proxy ou un load balancer réécrit l’adresse source, le WAF voit l’IP du proxy et la deuxième condition échoue pour tout le monde. L’agent légitime est alors bloqué, et l’usurpateur aussi, ce qui donne l’illusion d’une configuration correcte. Avant d’ouvrir l’accès, faites rejouer une requête de test depuis une IP de la liste, ou demandez à votre hébergeur de confirmer quel en-tête porte l’IP d’origine (X-Forwarded-For, CF-Connecting-IP ou équivalent).
La signature cryptographique remplace peu à peu le reverse DNS
Pour vérifier un robot Google, la méthode habituelle consiste à contrôler l’adresse IP et le reverse DNS. Google-Agent en ajoute une troisième : Web Bot Auth, un protocole qui fait signer chaque requête par l’opérateur selon la norme HTTP Message Signatures (RFC 9421). Une requête signée porte l’en-tête Signature-Agent: g="https://agent.bot.goog", et la clé publique se récupère à l’adresse https://agent.bot.goog/.well-known/http-message-signatures-directory. Le site vérifie la signature, et un usurpeur ne peut pas la produire.
Google ne se contente pas d’appliquer ce standard, il l’écrit. Le brouillon du groupe de travail webbotauth de l’IETF, HTTP Message Signatures for automated traffic, est signé par Thibault Meunier (Cloudflare) et Sandor Major (Google). Le groupe de travail l’a adopté en septembre, et sa révision -01 date du 29 octobre 2026.
Le déploiement reste partiel. La page Web Bot Auth de Google, mise à jour le 13 octobre, précise que seul un sous-ensemble des requêtes de Google-Agent est signé. Elle recommande de continuer à contrôler l’IP, le reverse DNS et le user-agent en parallèle. Arkose Labs, éditeur anti-bots, aurait mesuré que 2,3 % des sessions d’agents jugées légitimes portaient une signature valide.
Google n’est pas seul sur ce terrain. Le 13 novembre, OpenAI a demandé aux marchands, dans son guide ChatGPT Wallet, de reconnaître les requêtes signées de ses agents.
Pourquoi ça compte, et ce que vous devez faire
Pour un site transactionnel, le risque est commercial. Un client qui délègue une réservation ou un achat à Gemini n’attend pas que l’agent passe un CAPTCHA. Si la tâche échoue chez vous, l’agent la termine chez un concurrent, sans que l’échec apparaisse dans vos analytics. Les volumes restent faibles aujourd’hui : HUMAN attribuait à « Google Agent (Gemini) » 0,8 % des requêtes d’agents observées en octobre, loin derrière Meta. Mais la part n’a de sens que mesurée sur votre propre trafic, et l’exception se configure dans les réglages du CDN, sans développement.
Pour un média financé par la publicité, la décision est différente, et elle vous appartient. La page de Google ne la tranche pas. Bloquer un agent qui ne verra pas vos publicités se défend. Le bloquer sans le savoir, parce qu’un réglage par défaut l’a fait à votre place, ne se défend pas.
Dans l’ordre :
- Cherchez
Google-Agentdans vos logs serveur et CDN, et croisez les adresses avecuser-triggered-agents.json. Vous saurez s’il vient chez vous et quels codes de réponse il reçoit. - Ouvrez les réglages IA de votre CDN. Sur Cloudflare, vérifiez la position de la catégorie Agent, en particulier pour tout domaine créé après le 15 septembre.
- Créez une règle d’autorisation placée avant les blocages d’ASN et les règles anti-bots gérées, qui couvre les défis interactifs, les API et le tunnel de commande, pas seulement les pages HTML.
- Sortez les plages de Google-Agent de vos quotas par IP, ou appliquez-leur un seuil distinct.
- Demandez à votre fournisseur s’il vérifie Web Bot Auth. S’il ne le fait pas, conservez la vérification par IP, et vérifiez que vos proxys transmettent les en-têtes de signature.
Et si vous trouvez cela compliqué (« quel agent bloquer ? sur quelles pages ? »), demandez conseil à des spécialistes : nous sommes là pour vous aider.
Bibliographie
- Google, Allow Google-Agent traffic
- Google, List of Google user-triggered fetchers
- Google, Authenticate requests with Web Bot Auth (experimental)
- IETF, draft-ietf-webbotauth-httpsig-protocol
- Cloudflare, Your site, your rules: new AI traffic options for all customers
- Google, The new era of browsing: Putting Gemini to work in Chrome
- PPC Land, Google lists six ways sites still block its AI agent after allowing it
- PPC Land, Cloudflare drops planned Googlebot block for sites refusing AI training
- The Next Web, Gemini Spark, a 24/7 agentic assistant
- Clubic, Gemini Spark : Google ouvre son agent IA personnel au reste du monde, sauf chez nous
- Neper, Robots.txt et bots IA : comment protéger votre contenu sans disparaître des moteurs génératifs
- Neper, Cloudflare veut instaurer un péage pour les bots IA. Mais est-ce réaliste ?