Le 30 octobre 2026, Google, Microsoft, OpenAI et Anthropic ont annoncé qu’ils respecteraient une même ligne du fichier robots.txt permettant de refuser que vos contenus servent à entraîner leurs modèles d’IA.
Le texte qui la définit a été déposé le même jour à l’IETF par Kevin Kelley, ingénieur chez Anthropic. Elle propose un pseudo User Agent (ou pseudo token) : » __usage_ai-training« .
On pouvait donc se dire « super! on a enfin avancé sur le sujet qui avait créé un psychodrame cet été » : voir notre article ci-dessous si vous n’avez pas suivi le feuilleton Clouflare contre Google/Microsoft/Apple
Mais (et on pouvait s’y attendre) les grands acteurs de l’IA ont décidé de faire quelque chose de subtilement différent que ce que proposait Cloudflare (après : pourquoi pas).
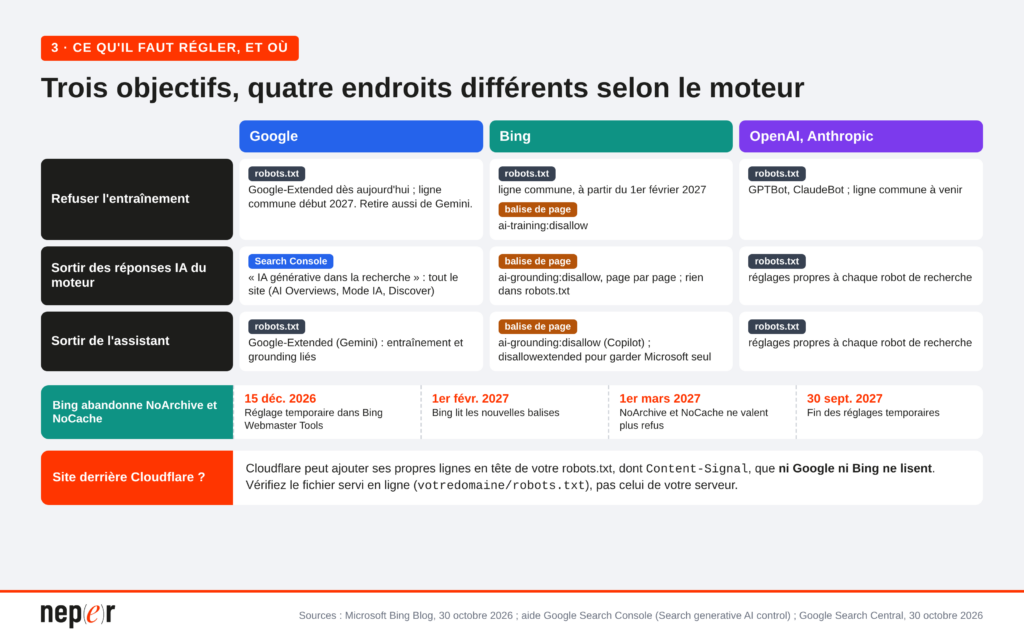
Et surtout, Google et Bing ont réussi à diverger sur la portée de la directive sur leurs outils : chez Google, cette ligne devrait aussi retirer votre site des réponses de Gemini, alors que chez Bing, elle ne change rien aux réponses de Copilot. Pour sortir des réponses générées par l’IA, chaque moteur impose par ailleurs son propre réglage, à un endroit différent.
Enfin, Bing annonce qu’il cessera de lire les balises NoArchive et NoCache le 1er mars 2027. Ce qui va faire diverger là aussi l’impact de ces balises entre Google et Bing.
Bref une belle cacophonie, et on est en plein syndrome de « pourquoi faire simple quand on peut faire compliqué ».
Ce que fait la ligne __usage_ai-training en théorie
__usage_ai-training est un pseudo token qui remplace un User Agent. Déjà on peut remarquer qu’il a une tête bizarre : deux caractères « _ » (tiret du 8) au début, un autre au milieu, et un « – » (tiret du 6) entre ai et training. C’est fait pour que cela puisse pas être confondu avec un vrai User Agent, mais écrit comme cela, bonjour les fautes de frappe potentielles !
Un fichier robots.txt est découpé en groupes. Chaque groupe commence par une ligne User-Agent qui nomme un robot, suivie de règles Disallow (interdit) et Allow (autorisé). Jusqu’ici, pour refuser l’entraînement, il fallait écrire un groupe par fournisseur : GPTBot pour OpenAI, ClaudeBot pour Anthropic, Google-Extended pour Google.
Le texte de Kevin Kelley garde exactement la même syntaxe, mais remplace le nom du robot par le nom d’un usage :
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Ces trois lignes signifient : « n’utilisez aucune page du site pour entraîner un modèle, sauf celles du dossier /press-kit/ ». Au sens du groupe de travail AIPREF de l’IETF, entraîner consiste à utiliser un contenu pour modifier les paramètres d’un modèle génératif. Le contenu ne sert pas à produire une réponse donnée : il est intégré au modèle, sans citation ni lien.
Trois points comptent en pratique :
- la ligne n’empêche pas les robots de crawler vos pages et ne change rien à votre présence dans les résultats de recherche ;
- un groupe
User-Agent: *, qui s’adresse à tous les robots, ne compte pas : sans groupe__usage_ai-training, vous n’avez exprimé aucune préférence ; - elle ne vaut que pour les pages récupérées après sa publication, pas pour les données déjà collectées.
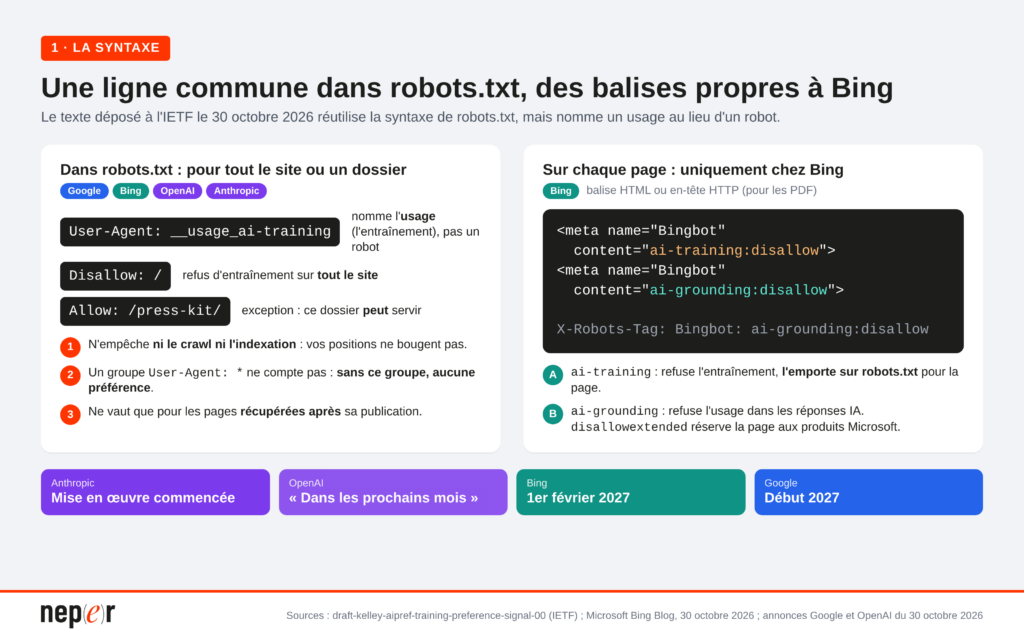
Les quatre fournisseurs conservent leurs propres réglages : GPTBot, ClaudeBot et Google-Extended continuent de fonctionner. Ils n’appliqueront pas non plus la ligne à la même date. Anthropic a commencé, OpenAI parle des « prochains mois », Microsoft du 1er février 2027 et Google de début 2027. Le texte lui-même n’est qu’une proposition individuelle, sans statut officiel à l’IETF, qui expire le 3 mai 2027 s’il n’est pas révisé.
Chez Google, la ligne retire aussi votre site des réponses de Gemini ; chez Bing, non
Il faut d’abord distinguer deux façons dont une IA utilise une page.
- L’entraînement, décrit plus haut : le contenu sert à fabriquer le modèle.
- Le grounding : quand un utilisateur pose une question, le moteur va chercher des pages dans son index et les fournit au modèle pour construire sa réponse. C’est ce mécanisme qui produit les citations et les liens dans Copilot, Gemini ou les AI Overviews.
Chez Bing, la ligne commune ne concerne que l’entraînement. Dans son billet, Krishna Madhavan, Principal Product Manager de Bing, précise que l’entraînement et le grounding sont deux préférences indépendantes, et que régler l’une ne modifie pas l’autre. Un site qui écrit Disallow: / sous __usage_ai-training continue donc d’apparaître comme source dans Copilot.
Chez Google, John Mueller explique que la ligne commune sera lue comme un refus de Google-Extended, sauf si le fichier contient déjà un groupe Google-Extended. Or Google-Extended n’est pas un robot : c’est un nom (token) que Google lit dans robots.txt pour savoir s’il peut utiliser vos pages dans Gemini, à la fois pour l’entraîner et pour le grounding dans l’application Gemini et dans Vertex AI, son offre destinée aux développeurs.
En rapprochant l’annonce de la page que Google consacre à Google-Extended, on en déduit que la même ligne devrait retirer votre site des réponses de Gemini. Google ne l’écrit pas explicitement dans son billet.
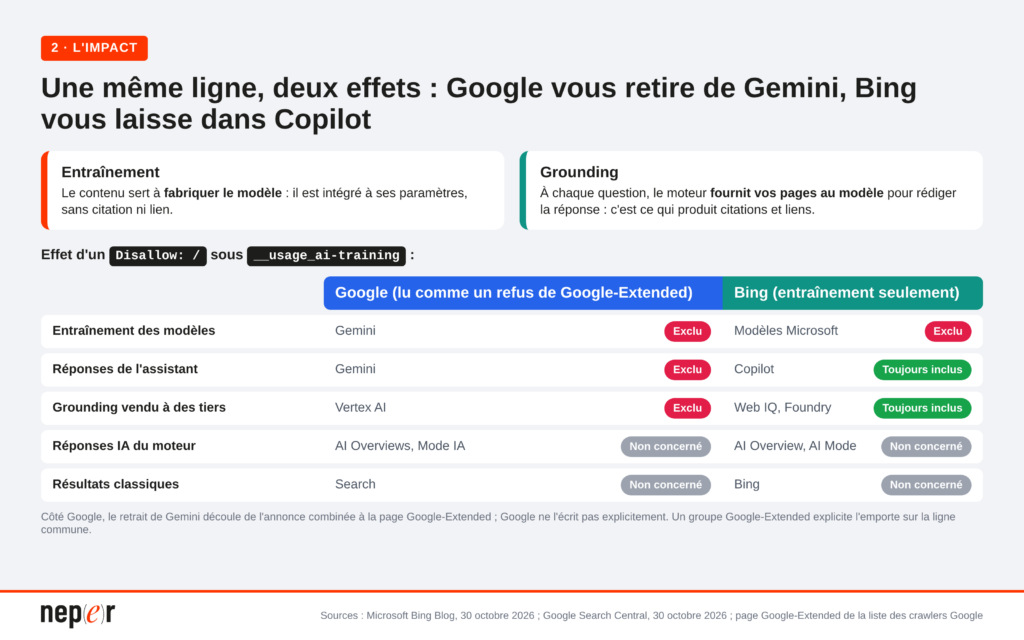
Prenons un site de recettes qui ajoute la ligne commune en 2027 pour refuser l’entraînement. Il ne sera plus cité quand un internaute interroge Gemini, mais il le restera quand ce même internaute interroge Copilot.
Pour rester dans Gemini, il faut ajouter un groupe User-Agent: Google-Extended avec Allow: /. Google appliquera alors ce groupe plutôt que la ligne commune. Mais Google-Extended ne distingue pas l’entraînement du grounding : autoriser l’un revient à autoriser l’autre.
Pour sortir des réponses IA, chaque moteur impose son propre réglage
Le pseudo token __usage_ai-training ne couvre que le pilotage de l’entraînement. Or c’est le grounding qui détermine si votre site est cité, ou simplement résumé, dans les réponses générées. Sur ce point, aucun standard n’existe, et Google et Bing ont choisi deux mécanismes incompatibles.
Google propose un réglage dans la Search Console, rubrique « IA générative dans la recherche ». Il a été créé sous la contrainte de la CMA, le régulateur britannique de la concurrence, qui l’a imposé le 3 juin 2026, et il est disponible dans le monde entier depuis le 31 août 2026. En choisissant « Exclure », vous retirez l’ensemble du site des AI Overviews, du Mode IA et des résumés générés dans Discover, sans perdre vos positions dans les résultats classiques. Ce réglage ne peut pas s’appliquer page par page, et il ne couvre pas l’application Gemini, qui dépend de Google-Extended.
Bing fait l’inverse : le réglage se fait page par page, et robots.txt ne propose aucun équivalent valable pour tout le site. Il faut ajouter une balise dans le code HTML de chaque page :
<meta name="Bingbot" content="ai-grounding:disallow">
On peut aussi transmettre la même instruction dans l’en-tête HTTP de la réponse, X-Robots-Tag: Bingbot: ai-grounding:disallow. C’est la seule solution pour un PDF.
Bing propose aussi une valeur intermédiaire, ai-grounding:disallowextended. Votre contenu reste alors utilisable par les produits de Microsoft (Copilot, Microsoft 365, AI Mode et AI Overview de Bing), mais pas par les services que Microsoft vend à d’autres entreprises pour alimenter leurs propres outils d’IA : Web IQ et l’API de grounding de Foundry, sa plateforme de développement d’IA sur Azure.
En pratique, pour sortir des réponses IA des deux moteurs, il faut cocher une case valable pour tout le site chez Google, et modifier chaque page pour Bing. Le réglage de l’un n’a aucun effet chez l’autre.
Bing cesse de lire NoArchive et NoCache le 1er mars 2027
En septembre 2023, Bing avait donné un sens nouveau à deux balises anciennes. NoArchive excluait une page des réponses de Bing Chat et de l’entraînement des modèles de Microsoft. NoCache autorisait la page dans les réponses, mais limitait ce qui pouvait en être affiché. Le billet du 30 octobre remplace ces deux balises par ai-training et ai-grounding, selon le calendrier suivant :
- 15 décembre 2026 : ouverture dans Bing Webmaster Tools d’un réglage temporaire de grounding, réservé aux sites qui utilisent NoArchive ou NoCache à cette date ;
- 1er février 2027 : Bing commence à lire les nouvelles balises à chacun de ses passages sur vos pages ;
- 1er mars 2027 : NoArchive et NoCache ne valent plus refus ;
- 30 septembre 2027 : fin des réglages temporaires.
Le problème, c’est que les nouvelles préférences sont réglées sur « autorisé » par défaut. Une page protégée par NoArchive depuis 2023, et que personne ne modifie, redeviendra utilisable par Copilot après le 1er mars.
Poser les nouvelles balises ne suffit pas non plus. Bing ne les verra qu’à son prochain passage sur la page, à une date que vous ne contrôlez pas. IndexNow, le protocole qui permet de signaler une page modifiée, augmente les chances d’un passage rapide sans rien garantir. Le réglage temporaire de Bing Webmaster Tools sert à couvrir ce délai, mais il ne vaut que pour le grounding. Pour l’entraînement, la ligne commune ou la balise ai-training:disallow doit être en place avant le 1er mars.
Chez Google, la balise noarchive est sans effet depuis la suppression du cache des pages en 2024.
Derrière Cloudflare, votre robots.txt contient des lignes que ni Google ni Bing ne lisent
Cloudflare, utilisé par 21,3 % des sites selon W3Techs en janvier 2026, peut écrire dans votre robots.txt à votre place. En septembre 2025, l’entreprise de Matthew Prince a lancé la Content Signals Policy : une ligne Content-Signal qui indique si un contenu peut servir à la recherche (search), aux réponses IA (ai-input) ou à l’entraînement (ai-train). Cloudflare l’a ajoutée automatiquement au robots.txt de 3,8 millions de domaines. Au lancement, Will Allen, de Cloudflare, reconnaissait que cette ligne n’était ni standardisée ni largement prise en charge. Depuis, ni Google ni Microsoft ne l’ont adoptée, et elle ne figure dans aucune des annonces du 30 octobre.
Le 15 septembre 2026, Cloudflare a ajouté un réglage Disallow AI Training, qui écrit dans le robots.txt les groupes propres à chaque fournisseur, comme Google-Extended et Applebot-Extended. Cloudflare précisait que ce réglage ne transmettait encore aucune préférence à Bing.
Sur un site derrière Cloudflare, le robots.txt que lisent les robots peut donc mélanger vos propres règles et celles que Cloudflare ajoute en tête du fichier. Le fichier présent sur votre serveur ne suffit pas pour savoir ce qui est réellement servi.
Apple, qui utilise Applebot-Extended pour permettre de refuser l’entraînement, ne fait pas partie des quatre signataires.
Pourquoi ça compte, et ce que vous devez faire
En 2027, deux situations vont se produire sans qu’aucun éditeur n’ait commis d’erreur de configuration :
- Un site qui ajoute la ligne commune pour refuser l’entraînement va disparaître des réponses de Gemini.
- Un site qui utilise NoArchive depuis 2023 redevient source de Copilot en mars sans avoir rien modifié
- Dans les deux cas, l’éditeur croit avoir réglé une chose et le moteur en applique une autre.
Ce qu’il faut faire dans l’ordre :
- Pour les sites présents à l’international : Repérez dès maintenant les pages qui portent NoArchive ou NoCache. Si vous voulez conserver l’exclusion chez Bing, ajoutez
ai-training:disallowetai-grounding:disallowavant le 1er mars 2027, et enregistrez le réglage temporaire dans Bing Webmaster Tools à partir du 15 décembre. - N’ajoutez jamais un groupe défini autour du token __usage_ai-training seul. Placez dans le même fichier un groupe Google-Extended qui indique explicitement si vous voulez rester dans Gemini, puisque Google appliquera ce groupe plutôt que la ligne commune.
- Gardez vos groupes GPTBot, ClaudeBot et Applebot-Extended. Aucun des quatre fournisseurs n’applique encore entièrement la ligne commune, et Apple ne s’est pas engagé.
- Réglez les réponses IA séparément pour chaque moteur : la Search Console pour Google, une balise sur chaque page pour Bing. Mesurez le trafic qu’elles vous apportent avant d’exclure quoi que ce soit.
- Si votre site est derrière Cloudflare, lisez le robots.txt servi en ligne (votredomaine/robots.txt), et non celui de votre serveur.
Bibliographie
- Your content, your choice: clearer preferences for training and grounding, Microsoft Bing Blog, 30 octobre 2026
- Machine-Readable Training Preference Signal, draft-kelley-aipref-training-preference-signal-00, IETF
- Search generative AI control, aide Google Search Console
- Announcing new options for webmasters to control usage of their content in Bing Chat, Bing Webmaster Blog, septembre 2023
- Have it both ways: stay discoverable in search while disallowing AI training, Cloudflare, 15 septembre 2026
- Giving users choice with Cloudflare’s new Content Signals Policy, Cloudflare
- Google Adopts New AI Training Control, Search Engine Roundtable, 30 octobre 2026
- OpenAI to Honor Shared Robots.txt Signal for AI Training Preferences, Unite.AI
- Google, Microsoft, OpenAI and Anthropic back one AI training opt-out, PPC Land
- What Opting Out Of Google’s AI Search Features Means Now, Search Engine Journal
- Cloudflare défie Google avec une refonte majeure de robots.txt : la Content Signals Policy, Neper
- Aperçus IA, mode IA : l’ADLC déjà saisie !, Neper
- Google promet un opt-out pour les AI Overviews : pourquoi les éditeurs n’ont rien à y gagner, Neper