
Dans l’épisode 115 du podcast Search Off the Record, publié en octobre 2026, Martin Splitt décrit ce que Google fait réellement d’un fichier PDF : un composant baptisé converter le transforme en page HTML, juste après le rendu et juste avant l’indexation. À partir de là, le reste de la chaîne ne voit plus qu’une page web.
Une règle pratique en découle : ce qui survit à cette conversion sert pour le référencement, c’est-à-dire le texte extractible, les liens et les métadonnées.
Ce qui n’y survit pas n’existe pas pour Google : les images, les pages scannées, la mise en page. Et comme un PDF ne peut porter aucune balise meta, presque tout le pilotage se fait dans l’en-tête HTTP que votre serveur envoie avec le fichier.
Un converter, et plus rien qui ressemble à un PDF
Martin Splitt explique ensuite pourquoi Google procède à cette conversion
Le PDF est un conteneur binaire : ouvert dans le même éditeur, il affiche une suite de caractères illisibles.
Google n’utilise pas de lecteur PDF. Il passe le fichier dans un converter, l’étape du pipeline d’indexation qui traduit un format de fichier en HTML. Il en existe pour le RTF, les documents Word, les feuilles Excel et même les documents Lotus Notes. Seules les images et les vidéos suivent un autre circuit.
Mueller l’avait déjà écrit sur Twitter en août 2018 : Google convertit les PDF et les formats voisins en HTML pour les indexer. Ce podcast récent précise l’emplacement de cette étape et ses conséquences.
L‘indexation et le classement sont donc gérés de la même façon que pour n’importe quel document. Martin Splitt résume en une phrase : « we don’t care if something was a PDF originally ». Un PDF peut donc apparaître dans les AI Overviews et dans l’AI Mode. Mueller ajoute qu’il en a vu cités par d’autres systèmes d’IA, qui s’en servent selon lui pour l’entraînement et pour le grounding, c’est-à-dire l’ancrage des réponses générées sur des documents récupérés au moment de la requête. Google indexe des PDF depuis 2001, et en comptait déjà des centaines de millions en 2011.
Le test du copier-coller
Par contre, pour que la conversion se passe bien, il faut que le PDF soit convertible.
Splitt désigne le pire cas : les pages rastérisées, où chaque page du PDF est stockée comme une image. Tout le texte est perdu pour Google. Le diagnostic qu’il propose prend dix secondes : ouvrir le PDF, tout sélectionner, copier, coller dans un éditeur de texte. Si le texte apparaît, Google peut le lire. S’il n’apparaît pas, le contenu est invisible.
Les PDF issus de numérisations posent le même problème. Sur ce point, les déclarations de Google ont glissé :
- En septembre 2011, Gary Illyes écrivait sur le blog Google que le moteur pouvait appliquer la reconnaissance optique de caractères (OCR) au texte intégré sous forme d’image.
- En 2026, Mueller dit que certains systèmes savent le faire, mais qu’on ne peut pas compter dessus.
Le test du copier-coller reste donc le seul contrôle fiable côté éditeur.
Deux autres cas aboutissent au même résultat :
- Un PDF protégé par mot de passe ou chiffré n’est pas indexé. Le blog de 2011 le disait, Splitt le répète.
- Les images intégrées ne vont pas dans Google Images. La recherche d’images travaille à partir d’URL d’images, et une image enfermée dans un PDF n’en a pas. Splitt pense que Google détecte leur présence sans pouvoir les traiter. La consigne de 2011 n’a pas changé : pour qu’une image soit indexée, elle doit figurer sur une page HTML.
Les liens sont bien conservés, mais pour leur « linkjuice » on ne sait pas
Les liens, eux, survivent à la conversion. Mueller le formule dans l’épisode : c’est parce que le PDF devient du HTML que les liens qu’il contient fonctionnent. Google les voit et peut les suivre.
Leur valeur en termes de signaux est une autre affaire, et les dires des Googlers sur le sujet ont un peu varié :
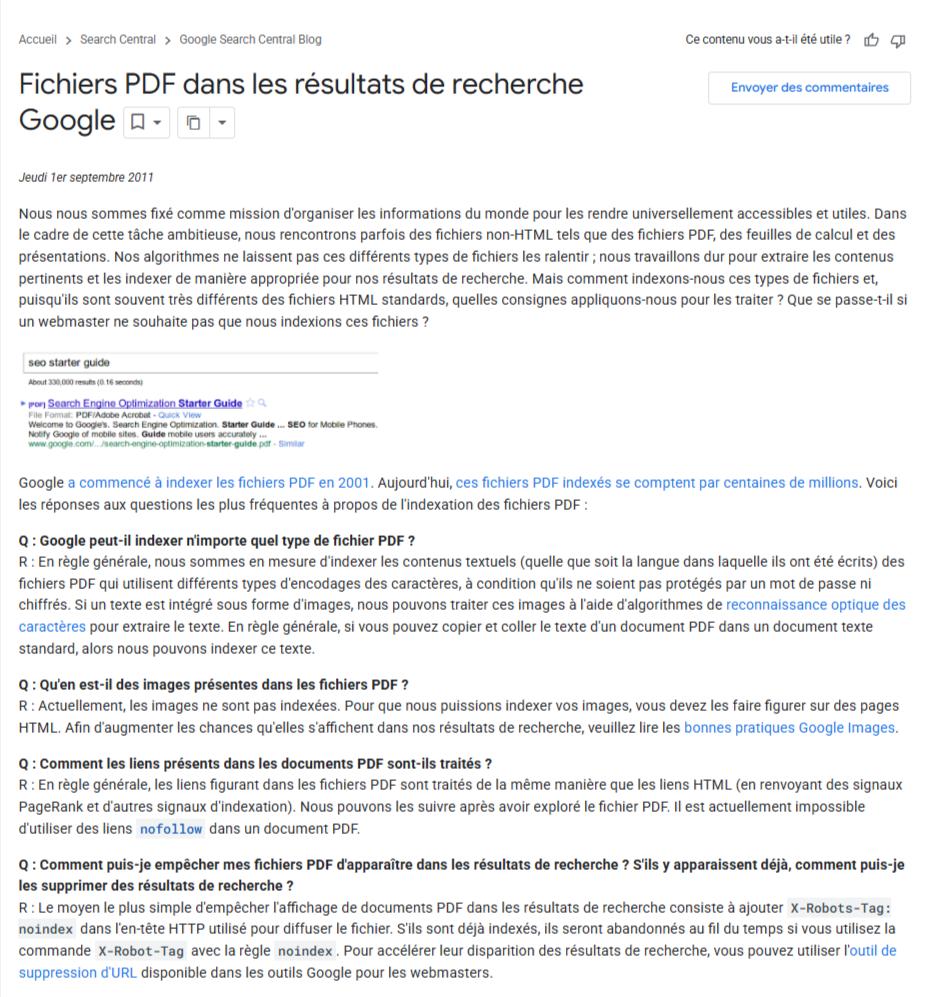
- Septembre 2011, blog Google : les liens des PDF sont traités comme des liens HTML, ils transmettent le PageRank et d’autres signaux. Le billet ajoute : « Il est actuellement impossible d’utiliser des liens nofollow dans un document PDF ».
- Juillet 2015 : Gary Illyes le confirme dans un commentaire sur Google+, à propos d’une campagne de spam de liens cachés dans des PDF repérée par Sophos.
- Janvier 2020 : lors d’un hangout, Mueller explique au contraire que, faute de moyen de signaler qu’un lien de PDF doit transmettre des signaux, Google les traite « similar to a nofollow link ». Le lien est reconnu, mais rien ne passe.
- Interpellé sur Twitter par Glenn Gabe, Mueller répond que Gary a probablement raison, et que l’effet pratique est de toute façon faible.
Personne chez Google n’a tranché depuis, et l’épisode de 2026 ne le fait pas non plus.
La conduite à tenir est la même dans les deux hypothèses : mettre des liens dans vos PDF pour l’utilisateur, et ne pas compter sur eux pour votre netlinking. Un lien acquis dans le PDF d’un tiers a une valeur incertaine. Un lien de votre PDF vers votre site a toujours une utilité : ramener le lecteur.
Les signaux à soigner à l’intérieur du fichier
Puisque le converter reproduit le PDF en HTML, ce que vous mettez dans le fichier devient le contenu de la page indexée. Quatre éléments comptent.
- Le titre. Le blog Google de 2011 indique que le titre affiché dans les résultats s’appuie sur deux éléments : la métadonnée Title du fichier et le texte d’ancre des liens qui pointent vers lui. Les deux se travaillent. Beaucoup de logiciels d’export remplissent ce champ avec le nom du fichier source, et c’est ce nom qui risque alors de s’afficher dans les résultats.
- Les métadonnées. Splitt recommande de remplir l’auteur, la description du contenu et, si possible, un lien vers l’emplacement d’origine du document.
- Le lien de retour en en-tête. Mueller recommandait déjà en décembre 2023, dans une vidéo AskGooglebot, d’insérer dans le PDF un lien vers le site. Dans l’épisode, il précise l’emplacement : en haut du document, dans l’en-tête. Le converter conserve ce lien, et un lecteur arrivé directement sur le PDF depuis un résultat de recherche ou une réponse d’IA retrouve votre site.
- La langue et la structure. Deux réglages d’export ne viennent pas de Google mais des normes du format :
- La langue du document, déclarée dans le PDF. La norme du format, ISO 32000, la prévoit au niveau du document entier.
- Le balisage structurel, appelé tagged PDF : titres hiérarchisés, ordre de lecture, textes alternatifs des images. C’est la condition de la norme d’accessibilité PDF/UA (ISO 14289).
Google ne dit pas si son convertisseur exploite ces informations. Leur intérêt certain porte sur les lecteurs d’écran, un point que Martin Splitt soulève à propos des pages rastérisées.
Dernier levier : pemrettre la découverte du PDF lors de l’exploration par le crawler. John Mueller décrit Google trouvant un nouveau PDF par un lien. Un PDF lié depuis vos pages et listé dans votre sitemap XML est découvert et compris plus vite qu’un fichier accessible par une seule page de téléchargement.
Pas de balise meta : tout passe par l’en-tête HTTP
Une page HTML porte ses consignes dans son code. Un PDF ne le peut pas.
Les directives se placent donc dans l’en-tête HTTP, les lignes que le serveur envoie avant le fichier lui-même.
Pour désindexer, le blog de 2011 donne la méthode : X-Robots-Tag: noindex, l’équivalent de la balise meta robots, transmis par en-tête. Le robots.txt a un autre effet : Splitt rappelle qu’il empêche Google de lire le PDF, ce qui bloque l’exploration mais pas l’indexation d’une URL déjà connue. Et si le robots.txt interdit l’accès au fichier, Google ne voit pas non plus son X-Robots-Tag.
Pour la canonicalisation, l’en-tête Link accepte un rel="canonical". Mueller reconnaît dans l’épisode que peu d’éditeurs le font, parce que c’est fastidieux. Le cas qui le justifie le plus est celui des doublons binaires : quand un tiers télécharge votre PDF et le republie, les deux fichiers sont identiques octet pour octet. Pour Google, il ne s’agit pas d’une page similaire mais du même objet, ce qui rend le choix de l’original plus difficile, comme pour les images.
Pour le cache, Splitt conseille de régler la durée de mise en cache HTTP sur le rythme réel de mise à jour. Un catalogue revu chaque trimestre peut rester en cache plusieurs mois.
Voici ce que peut envoyer un serveur pour un PDF qui ne doit pas être indexé à la place de sa version HTML :
HTTP/1.1 200 OK
Content-Type: application/pdf
Link: <https://www.exemple.fr/catalogue-2026>; rel="canonical"
Cache-Control: max-age=7776000
Pour un PDF à exclure entièrement, la ligne Link est remplacée par X-Robots-Tag: noindex.
Les PDFs sont recrawlés à la vitesse d’une tortue asthmatique
Le PDF a un second handicap, moins visible : Google les rafraichit rarement.
John Mueller l’expliquait dès février 2016 : Google suppose qu’un PDF reste stable et ne le rafraîchit pas aussi vite qu’une page HTML. En 2026, il fait le parallèle avec les images. Les systèmes ne vont pas retélécharger toutes les quelques minutes des fichiers volumineux qu’ils jugent figés, notamment pour ne pas surcharger les serveurs.
Conséquence directe : écraser un PDF par sa nouvelle version ne garantit pas que Google la verra rapidement. La recommandation de John Mueller est de publier la mise à jour sous un nouveau nom de fichier. Google trouvera un lien vers cette nouvelle URL, la traitera comme nouvelle et l’explorera.
Le même mécanisme rend dangereux les PDF générés automatiquement. John Mueller raconte le cas d’un CMS, peut-être Joomla, qui proposait une version PDF de chaque page. L’ancienne version du contenu restait indexée en PDF pendant que la nouvelle l’était en HTML : deux documents qui se concurrencent et qui, en plus, se contredisent.
Sa consigne vaut pour tout contenu dynamique, une carte régionale générée à la volée par exemple : empêcher son exploration et son indexation. Il avait déjà fait cette exception en janvier 2010 sur le forum d’aide de Google, en jugeant ces copies automatiques « likely not compelling enough to merit getting indexed separately ». Il ajoutait qu’elles chargent le serveur pour rien.
Pour les doublons voulus, Google est plus détendu. Gary Illyes écrivait en février 2016 qu’il n’y avait pas lieu de s’inquiéter de la duplication interne. Mueller disait en août 2016 qu’un PDF téléchargeable reprenant le contenu d’une page ne posait aucun problème. Il ajoutait en 2023 que Google privilégie en général la version HTML quand il voit les deux comme des doublons.
Taille et mobile : les limites physiques du format
64 Mo : c’est le plafond d’exploration d’un PDF par Googlebot, inscrit dans la page d’aide de Google consacrée au robot depuis février 2026. Pour comparaison, le plafond est de 2 Mo pour une page HTML. Au-delà de la limite, Googlebot interrompt le téléchargement et n’envoie à l’indexation que la partie déjà récupérée. La limite s’applique aux données non compressées.
Le chiffre est public depuis huit mois, pourtant Martin Splitt dit dans l’épisode ne pas connaître la limite des PDF. Il explique la réticence de Google à l’afficher : le seuil peut changer, et un chiffre publié circule ensuite pendant des années. Mueller invite les référenceurs à mesurer la coupure eux-mêmes avec un livre du projet Gutenberg.
En pratique, peu de PDF approchent 64 Mo. Mueller pointe un problème plus fréquent : un PDF de la taille d’un livre se classe mal, comme une page HTML qui contiendrait un livre entier. Google peine à déterminer quelle phrase justifie de classer le document sur une requête donnée. Un sujet par document reste la meilleure option.
Sur mobile, Splitt relève deux défauts :
- Le PDF doit être téléchargé entièrement avant de s’afficher, là où le HTML montre quelque chose dès les premiers octets.
- Le texte ne se réajuste pas quand on zoome, parce qu’il suit une mise en page d’impression.
En 2018, Mueller indiquait d’ailleurs que Google n’étiquetait aucun PDF comme « mobile-friendly ». Le label a disparu depuis, pas le problème.
Le premier défaut a une réponse technique : la linéarisation, appelée « Fast Web View » dans Acrobat et décrite dans une annexe de la norme ISO 32000. Un PDF linéarisé range ses données de façon à ce que la première page s’affiche avant la fin du téléchargement, à condition que le serveur accepte les requêtes partielles (requêtes HTTP Range). C’est une option d’export, souvent désactivée par défaut.
Quand le PDF reste le bon format
Rien de tout cela ne conduit Google à déconseiller le PDF. Splitt en approuve l’usage quand le contenu l’exige :
- une mise en forme précise ;
- un rendu imprimé fidèle ;
- un formulaire, comme la fiche d’inscription d’un gîte qu’il prend en exemple.
Mueller ajoutait en 2023 les guides et les études de cas, qui fonctionnent dans les deux formats.
Le menu de restaurant sert de cas d’école dans les deux interventions. En 2023, Mueller estimait qu’une page HTML convient mieux, parce que les clients consultent le menu sur leur téléphone. En 2026, il se montre pragmatique : un menu en PDF vaut mieux que pas de menu du tout. Une petite structure qui manque de temps peut s’en contenter, à condition que le texte passe le test du copier-coller.
Une exception ne souffre pas de discussion : le llms.txt ne se publie jamais en PDF. C’est la blague qui ouvre l’épisode, mais la réponse est sérieuse (en même temps, qui pense encore que le llms.txt est une bonne idée).
Côté GEO (Generative Engine Optimization), le X-Robots-Tag ne règle que l’indexation par Google. Les robots qui collectent des contenus pour entraîner des modèles se pilotent par le robots.txt, avec un jeton par robot :
- GPTBot chez OpenAI ;
- Google-Extended chez Google, qui couvre l’entraînement et le grounding des modèles Gemini sans toucher au classement dans la recherche Google.
Les rapports, livres blancs et études publiés en PDF sont souvent les contenus qu’un éditeur hésite le plus à laisser collecter.
La décision se prend robot par robot, et elle vaut aussi pour les PDF.
Pourquoi ça compte, et ce que vous devez faire
Les PDF concentrent souvent les contenus les plus coûteux d’un site : études, rapports annuels, livres blancs, fiches techniques.
Ce sont aussi les moins surveillés : c’est un angle mort du référencement.
Si vous ne voulez pas que vos Pdfs soient indexés ou crawlés : les directives x-robots-tag sont là pour ça.
Si au contraire, vos PDFs sont intéressants pour le SEO : alors n’hésitez pas à créer une page HTML qui résume votre PDF (elle ne sera pas considérée comme un doublon et se positionnera plus facilement que le PDF).
Et optimisez vos contenus PDF :
- Passez vos PDF indexés au test du copier-coller. Remplacez ceux dont le texte n’apparaît pas par une version texte, ou publiez le contenu en HTML.
- Contrôlez le champ Title et l’auteur de chaque PDF avant mise en ligne, et vérifiez que les liens qui pointent vers lui portent une ancre descriptive.
- Vérifiez ce que votre serveur envoie pour les fichiers .pdf. Un
X-Robots-Tag: noindexpour les copies automatiques et les documents dynamiques, unLink rel="canonical"vers la page HTML quand elle existe, unCache-Controlaligné sur le rythme de mise à jour. - Publiez chaque nouvelle version sous un nouveau nom de fichier, et mettez à jour les liens qui pointent vers elle.
- Exportez avec un lien vers votre site en en-tête, la langue déclarée, le balisage structurel et la linéarisation activés.
Bibliographie
- Search Off the Record, épisode 115 : PDFs in Search: Indexing, AI & Pitfalls
- Google Search Central, « Fichiers PDF dans les résultats de recherche Google » (septembre 2011)
- Google Search Central, page d’aide sur Googlebot (limites de taille des fichiers)
- Google Search Central, « Au cœur de Googlebot : démystifier l’exploration, l’extraction et les octets que nous traitons » (mars 2026)
- Google, présentation des robots d’exploration et des extracteurs Google
- AskGooglebot, John Mueller : publier un contenu en HTML et en PDF (décembre 2023)
- John Mueller, hangout de janvier 2020 (liens dans les PDF, à 9:43)
- OpenAI, présentation des robots d’exploration d’OpenAI
- ISO 32000-2:2020, format PDF 2.0
- ISO 14289-1, PDF/UA (accessibilité des PDF)
- Search Engine Roundtable, « Google Search On PDFs: Conversion, Links, HTML, Ranking, Limits, Crawling » (octobre 2026)
- Search Engine Roundtable, « Did Google Just Say Links In PDFs Treated As Nofollow Links? » (janvier 2020)
- Search Engine Roundtable, « Duplicate Content Between HTML & PDF Pages? Google Should Figure It Out » (janvier 2010)
- Search Engine Roundtable, « Google Indexes PDF Documents But Refreshes Them Slowly » (février 2016)