
Le 16 août 2026, six ingénieurs de Google ont mis en ligne sur arXiv un papier qui sera présenté à la conférence CIKM 2026, à Rome, du 7 au 11 novembre.
Di Bai, Feng Han, Zhenwei Tang, Jintao Liu, Luoshu Wang et Jialu Liu y décrivent SDF (Supersession-Decay Filtering), un système qu’ils disent « complètement déployé dans Google Discover » depuis deux ans. Son rôle : retirer du flux les contenus périmés, avant l’étape de classement. Sur la période, les signalements « contenu périmé » déposés par les utilisateurs de Discover auraient baissé de 54,9 % d’après l’article.
Ce « papier » scientifique révèle quelques informations intéressantes.
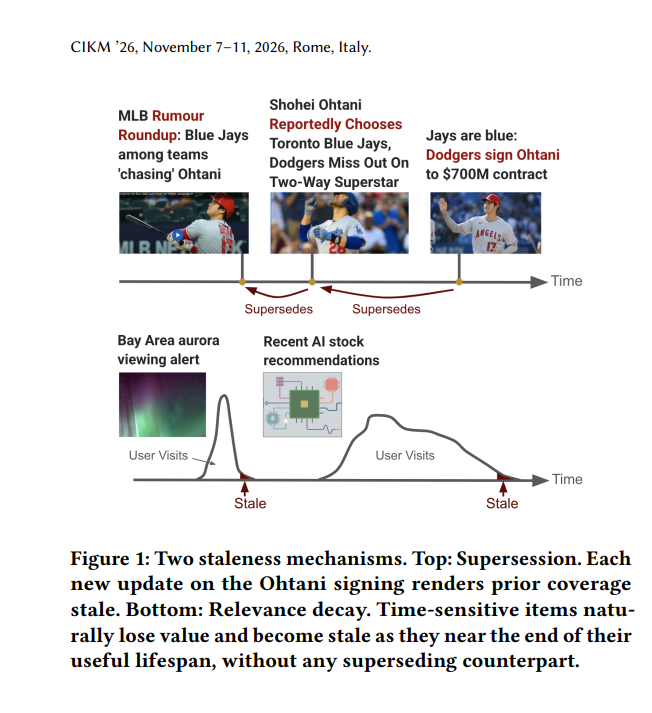
Notamment, le fait qu’un article peut sortir de Discover pour deux raisons sans rapport avec sa qualité :
- un autre site a publié un article plus à jour (la suite de l’histoire),
- ou son contenu laisse prévoir une durée de vie courte.
La durée de vie Discover d’un article se joue donc en grande partie au moment où vous choisissez l’angle ou le format de l’article, pas après sa publication.
Un filtre placé avant le classement, pas un signal de ranking
Discover fonctionne comme la plupart des systèmes de recommandation à grande échelle : un ensemble de contenus candidats (le candidate set) est constitué, puis un modèle de ranking, coûteux en calcul, choisit ce qui sera montré à chaque utilisateur.
SDF agit entre les deux. Il retire des candidats tout article jugé périmé, et le classement ne voit jamais ces articles.
C’est une différence de nature avec un facteur de fraîcheur classique. Un signal de ranking fait reculer un contenu. SDF le rend carrément inéligible pour être affiché dans les flux Discover.
Côté Search Console, cela se traduit par un trafic qui s’arrête net, et non par une érosion progressive.
Trois propriétés du système SDF sont à noter :
- Les scores ne sont pas personnalisés. Ils dépendent de l’article et du temps écoulé, jamais de l’utilisateur. Un article périmé l’est pour tout le monde.
- Ils sont calculés en dehors des requêtes, puis mis en cache. SDF évalue plusieurs millions de nouveaux contenus par jour.
- Google y trouve aussi un intérêt économique. Au premier trimestre 2026, les deux filtres ont réduit de 4,76 % et 3,98 % les heures de CPU et de TPU consommées par le classement. Chaque article retiré en amont est un article que le modèle de ranking n’a pas à noter.
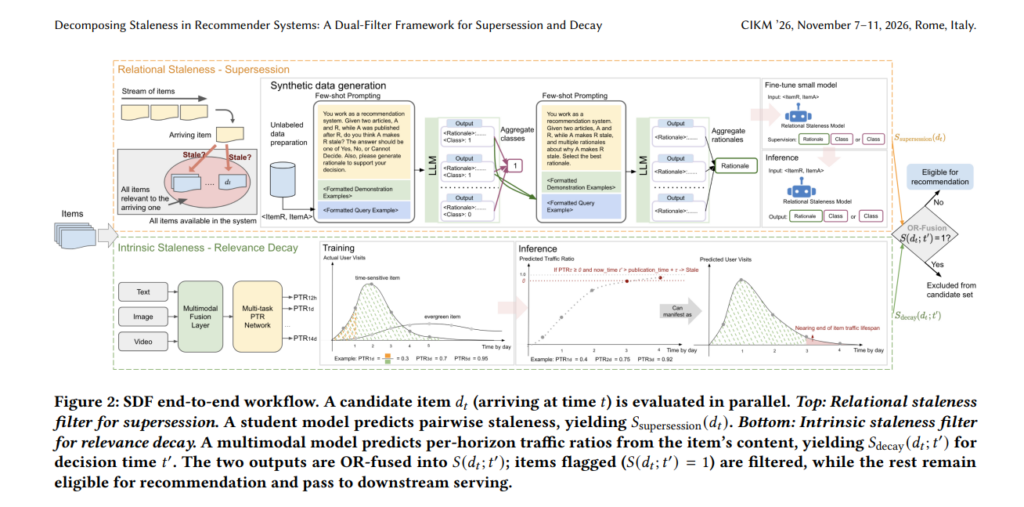
Le papier distingue deux façons de devenir périmé, traitées chacune par un filtre. Il suffit que l’un des deux se déclenche pour que l’article soit retiré.
La supersession : votre article sorti au profit de celui d’un concurrent
Le premier filtre traite la notion de supersession : un article devient périmé quand un article plus récent sur le même sujet traite la suite de l’histoire.
Les auteurs prennent l’exemple de Shohei Ohtani. Un article indiquant que le joueur étudiait les offres de plusieurs clubs est devenu caduc à l’instant où sa signature aux Dodgers a été annoncée.
Le jugement est relationnel : le système compare des paires d’articles qui portent sur le même événement ou la même entité, et se demande si le second rend le premier obsolète. Rien dans le papier ne limite cette comparaison aux articles d’un même éditeur.
Votre article peut donc être classé comme « caduc » à cause d’un contenu concurrent. Et vous disparaissez de Discover dès que ce constat est fait.
La mécanique d’entraînement explique la finesse du jugement :
- PaLM 2 a étiqueté 1 100 133 paires d’articles, chaque paire étant soumise sept fois au modèle avec un vote à la majorité.
- Ce savoir a été transféré par knowledge distillation dans un modèle T5 de 11 milliards de paramètres, entraîné à rédiger une courte justification avant de rendre sa décision.
- Sur 550 paires notées par des humains, le modèle atteint 83,5 % de précision et 95 % de rappel.
Deux exemples publiés montrent où passe la ligne.
- Un article sur la série Athletics contre Rangers est jugé périmé par le compte rendu de cette série.
- En revanche, un rapport général de CoreLogic sur le marché immobilier australien ne périme pas un article consacré à la fin des taux fixes, parce que le premier n’aborde pas ce point. Un angle précis résiste mieux qu’un angle général.
Dernier détail, important pour les sites qui publient plusieurs déclinaisons d’un même sujet : le mode batch étend l’étiquette « périmé » aux autres articles du même cluster. Les reprises proches d’une information dépassée tombent ensemble.
Le PTR : une date d’expiration calculée avant le premier clic
Le second filtre traite le relevance decay, la perte de valeur naturelle d’un contenu sans qu’aucun autre ne le remplace. Exemple du papier : un guide pour observer les Géminides utile un soir, inutile le lendemain.
Le modèle s’appelle PTR (predicted traffic ratio). Pour chaque article, il prédit quelle part de son trafic des 30 premiers jours il aura reçue après 12 heures, 1, 3, 5, 7, 10 et 14 jours. Quand cette part atteint 90 % à l’âge qu’a l’article, celui-ci est retiré : il a, selon le modèle, déjà consommé l’essentiel de son audience.
Voici comment fonctionne le PTR :
- La prédiction se fait sur le contenu seul, avant toute donnée d’engagement. Le texte, les images et la vidéo sont lus ensemble par un même encodeur multimodal. Un visuel qui crie l’instantané compte autant qu’un titre.
- Le modèle est entraîné sur les clics issus de la recherche Google, pas sur les vues Discover. Les auteurs écartent ces dernières parce qu’elles sont biaisées par la promotion des éditeurs. Le PTR apprend donc la durée de vie d’un sujet à partir de la façon dont les internautes cessent de le chercher.
- L’horloge démarre à l’annotation de l’article par la chaîne d’indexation, que les auteurs assimilent à sa date de publication. Rien n’indique qu’une date affichée modifiée la remette à zéro.
Le papier cite trois cas réussis : le guide des Géminides retiré après l’événement, un guide du festival gastronomique de Phuket conservé pendant les jours du festival, et un article explicatif du New York Times sur le coaching santé laissé intact. Un contenu explicatif conserve son éligibilité, une brève liée à un instant la perd vite. Sur des contenus notés par cinq évaluateurs humains, la précision du PTR dépasse 88 %.
Les angles morts du système SDF
Les auteurs signalent eux-mêmes trois angles morts, utiles pour un éditeur parce qu’ils indiquent où SDF n’intervient pas.
- Le commentaire politique. Quand un texte mêle opinion et faits, aucun article ne remplace clairement un autre, et le filtre de supersession tranche mal. Les tribunes et analyses sont, de fait, moins exposées.
- Les contenus qui déclinent lentement. Leur ratio n’atteint jamais 90 %, et certains restent dans le flux alors qu’ils sont devenus moyennement périmés.
- Le déjà-vu. Une part importante des signalements restants porte sur des contenus que l’utilisateur a déjà vus sur Discover ou ailleurs. SDF ne traite pas ce cas.
SDF : Un impact faible sur le trafic
D’après l’article, l’effet sur l’audience reste faible. Sur un test de deux mois où une partie des utilisateurs était privée des deux filtres, SDF fait baisser les rejets de cartes de 0,16 % et progresser l’engagement positif de 0,26 %. Les filtres ont été réglés pour ne pas réduire l’engagement. Le gain principal porte sur la perception de fraîcheur et sur le coût de calcul, pas sur le volume de clics.
Quand a été déployé SDF ? Deux ans de déploiement avant août 2026 situent le démarrage vers mi-2024 : SDF n’est pas la mise à jour Discover de février 2026, même s’il sert le même objectif de contenus actuels.
Le papier mentionne une extension progressive à d’autres pays et langues et un entraînement multilingue, sans préciser si la France est couverte. Enfin, les modèles décrits (PaLM 2, T5) ont été remplacés au fil des versions selon les auteurs, et les seuils actuels ne sont pas publics.
Relire vos courbes Discover avec cette grille
SDF donne une clé de lecture pour des profils de trafic que les éditeurs constatent sans pouvoir les expliquer. Dans le rapport Discover de la Search Console, ou dans un outil de suivi par URL, trois formes de courbe deviennent interprétables.
- Une chute à zéro en quelques heures, juste après une annonce officielle ou la publication d’un article concurrent sur le même sujet, correspond au profil d’une supersession. L’article n’a pas été déclassé pour un défaut de qualité : il a été remplacé dans les candidats par un contenu plus récent.
- Un arrêt net entre trois et sept jours après publication, sans événement extérieur, correspond au profil d’un seuil PTR atteint. C’est la durée de vie que le modèle avait prévue pour ce type de contenu dès la première lecture.
- Une décroissance lente sur plusieurs semaines correspond au comportement d’un contenu que le PTR juge durable, et que seul le classement module ensuite.
Ce ne sont pas des preuves : juste des indices que cela peut être dû au système SDF
Concrètement, quels enseignements en tirer ?
Les gestes, par ordre de priorité :
- Publiez sur le dénouement le premier. Et sachez que votre Sur l’actualité chaude, l’article qui apporte la suite est celui qui reste éligible. La vitesse sur l’information qui fait avancer l’histoire compte plus que la vitesse sur la rumeur.
- Choisissez l’angle en connaissant sa durée de vie. Un article sur une situation provisoire a une date d’expiration. Si vous voulez de la longévité, préférez l’angle explicatif ou analytique, et un sous-sujet précis qu’un article général ne viendra pas remplacer.
- Alignez titre, texte et visuel sur la durée de vie prévue du contenu. Le PTR lit les trois ensemble. Un guide durable illustré par un bandeau « en direct » envoie un signal contradictoire.
- Mesurez la durée de vie médiane par format et le lifespan de vos articles. C’est le seul moyen de vérifier, sur votre site, quels contenus SDF raccourcit et lesquels il laisse vivre.
Bibliographie
- Di Bai et al., « Decomposing Staleness in Recommender Systems: A Dual-Filter Framework for Supersession and Decay », arXiv:2608.15780, CIKM 2026
- Google Search Central, « Mise à jour principale de Google Discover de février 2026 »
- Google Search Central, « Google Discover et votre site Web »
- Roger Montti, « Details emerge about Google Discover’s SDF freshness algorithm », Search Engine Journal, 21 octobre 2026