Un des phénomènes les plus récurrents que je vois chez mes clients c’est l’indexation de sous-domaines ou de hosts techniques qui ne sont pas prévus pour figurer dans les pages référencées du site.
Quand il s’agit de sites de recette ou de preprod, c’est encore plus embêtant car ce sont des miroirs du site en production, et Google Search n’aime pas les sites miroirs depuis très très longtemps.
Je vous donne donc une astuce très simple pour le vérifier, par une simple requête dans Google.
La requête ultime pour repérer les Ghost Hosts, vos sites « fantômes »
Tapez dans Google cette requête
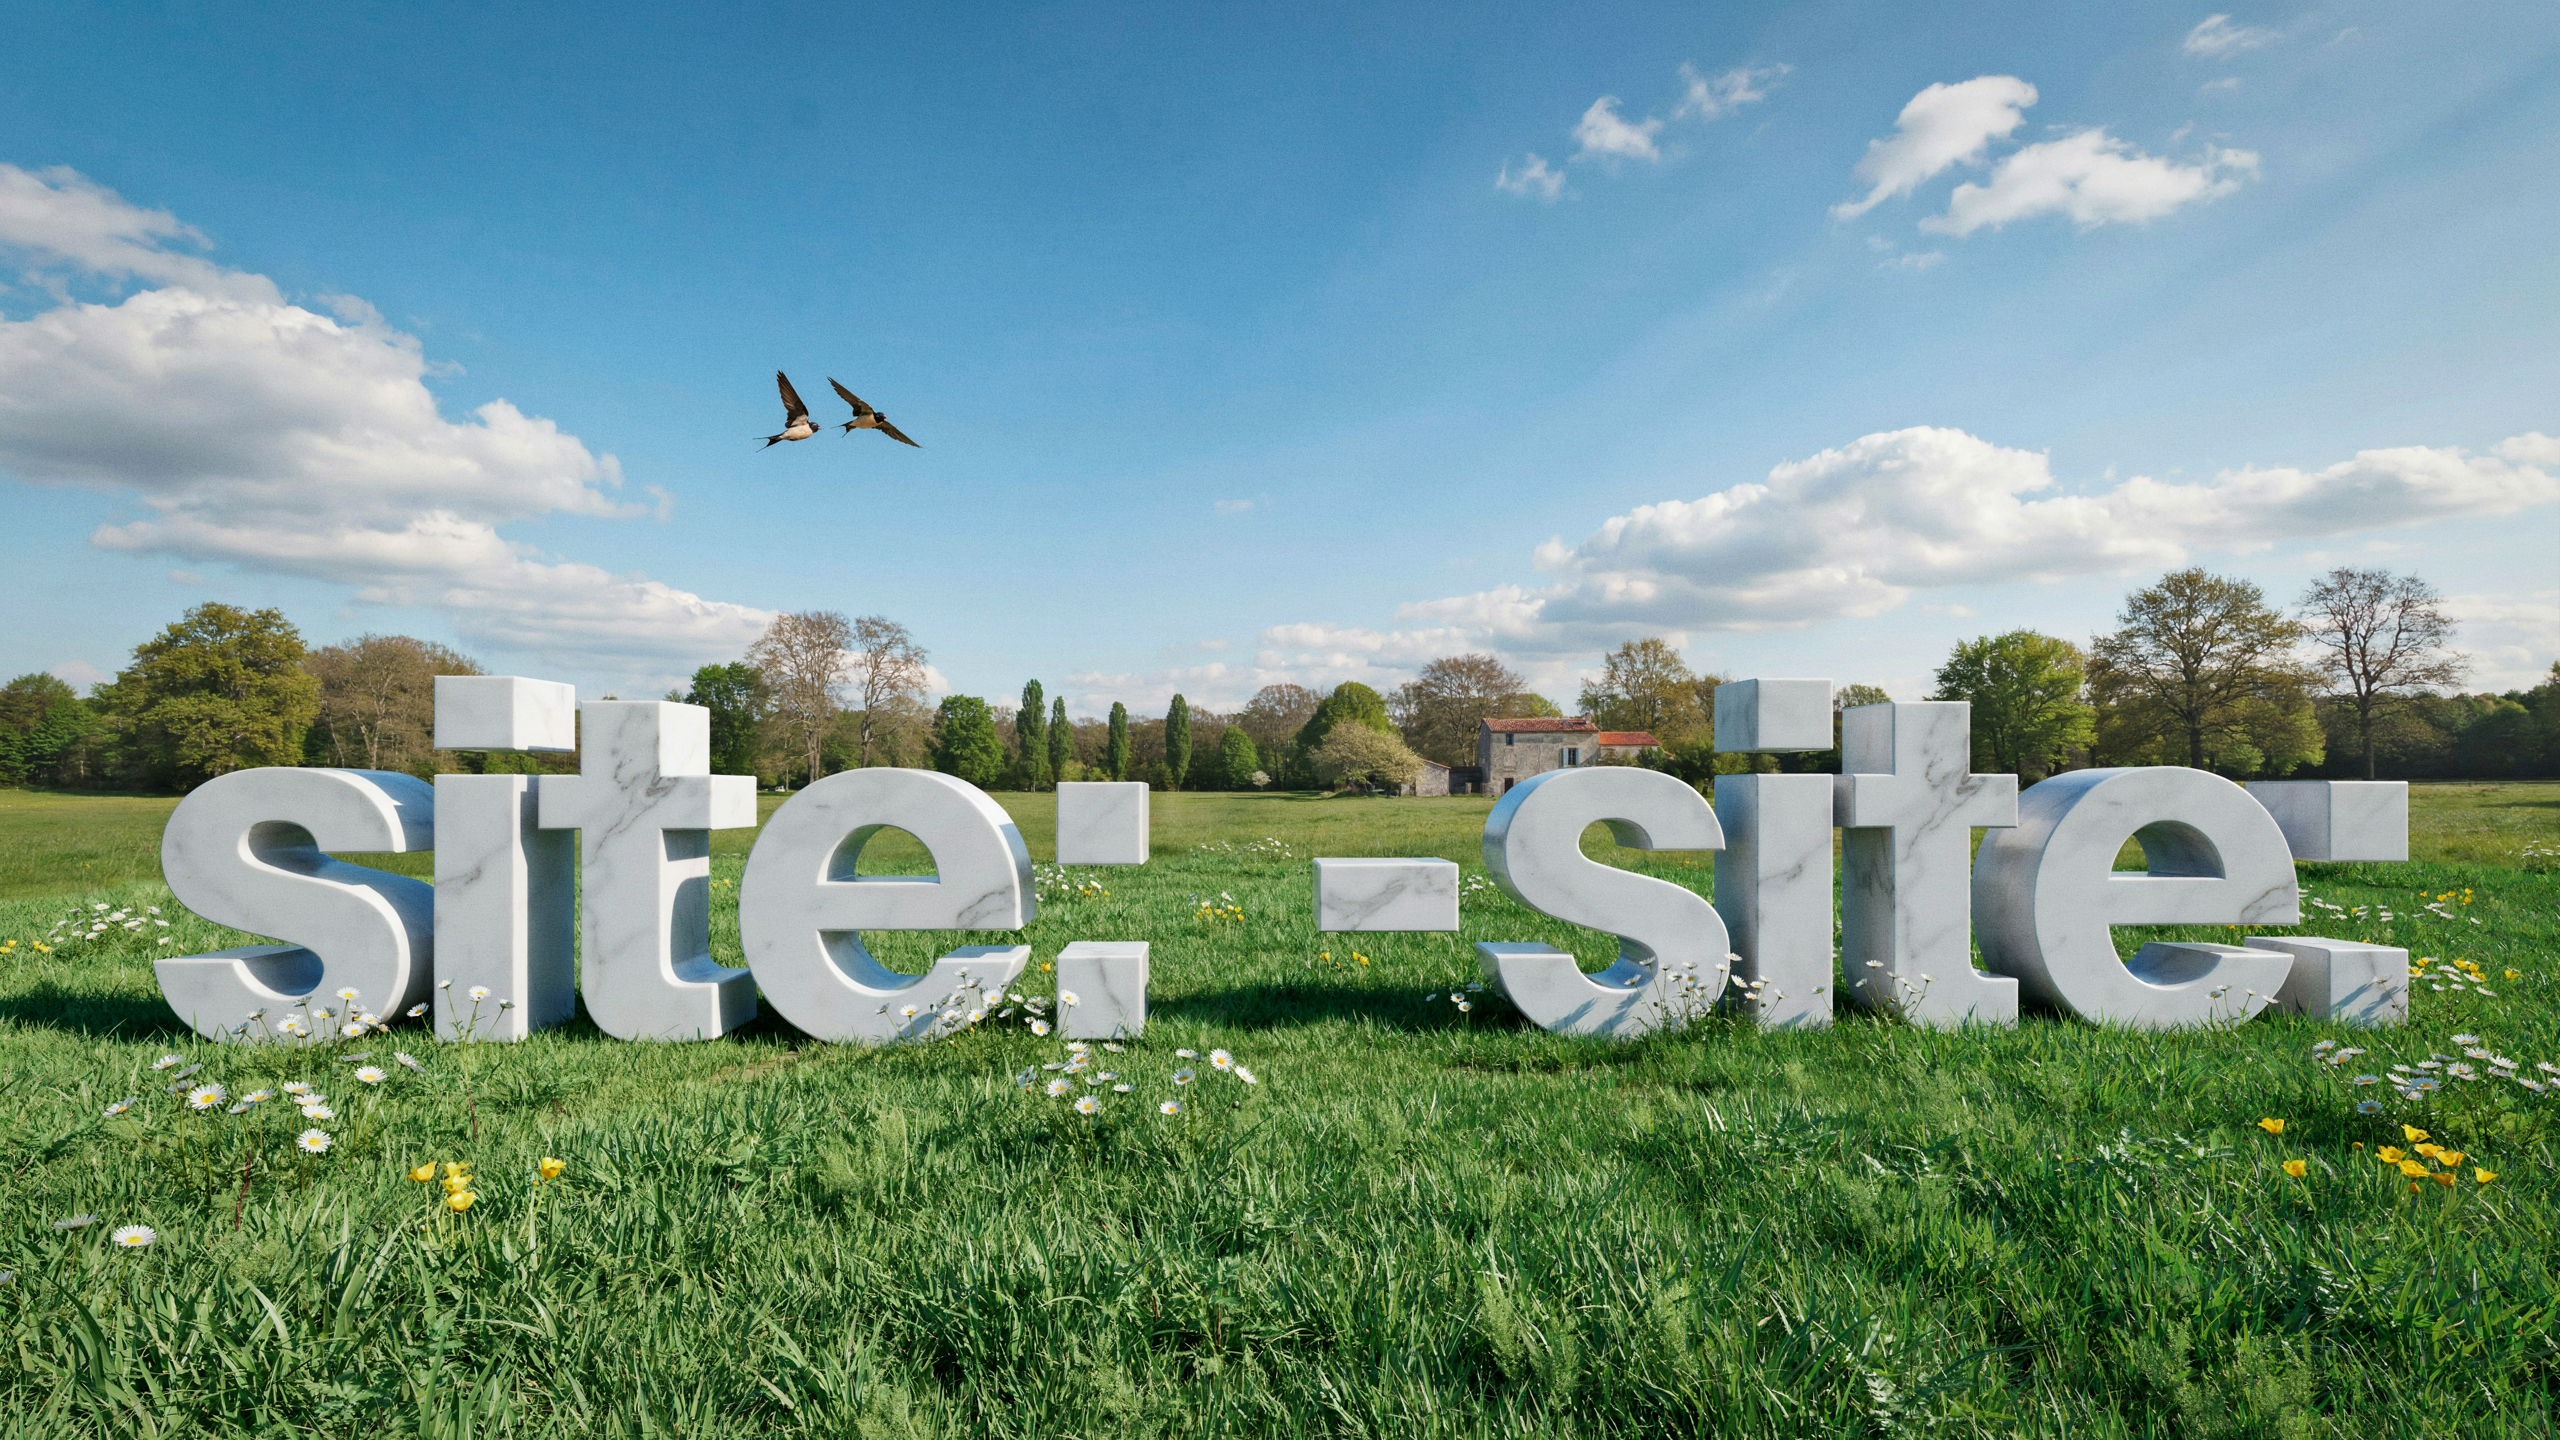
site:[votredomaine.com] -site:www.[votredomaine.com]Attention : il n’y a pas d’espace entre site: et le domaine. Et ne placez pas votre domaine entre crochets.
Voilà ce que cela donne en vrai :
site:wikipedia.com -site:www.wikipedia.comEt vous obtenez les pages indexées de votre domaine qui ne sont pas dans le www. Dans la liste qui apparait, vous allez trouver :
- des sous-domaines (hosts) qui sont prévus pour l’indexation
- et d’autres non : ce vos sous domaines suspects
Pourquoi cette syntaxe bizarre fonctionne ?
Le signe « – » (moins) dans la deuxième partie est un .NOT. logique, c’est un signe d’exclusion. La requête se traduit en :
Donne moi toutes les urls indexées du site [domaine.com] en excluant les urls indexées du site www.[domaine.com]
Ces syntaxes avec des opérateurs sont très anciennes, elles datent d’avant Google. Et pour info, cette requête fonctionne aussi sur Bing.
Les exclusions se combinent. Par exemple, pour trouver les hosts bizarre indexés, il faut parfois exclure les pages d’autres hosts que le www. Par exemple :
site:domaine.com -site:www.domaine.com -site:forum.domaine.com -site:support.domaine.comBref en éliminant les sous-domaines « légitimes » avec des milliers de pages, vous allez finir par tomber plus facilement sur les cas bizarres.
Pourquoi j’ai un recaptcha ?
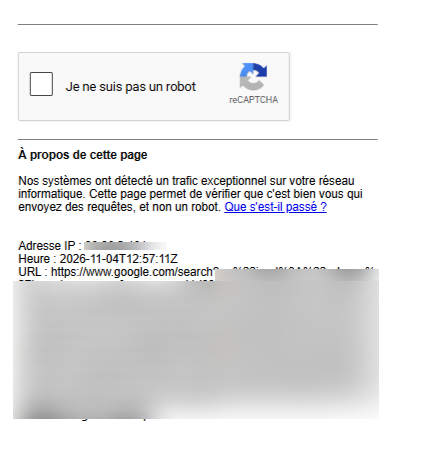
Si cela déclenche un recaptcha ou un challenge, c’est normal. Les opérateurs utilisés sont caractéristiques soit d’un utilisateur avancé de Google, soit d’un petit malin en train de s’adonner à ce qu’on appelle dans le jargon du « dorking ». Et le dorking n’est pas du tout du goût des Googlers. Ce sont souvent des « bots » qui font ce genre de requêtes, pas des humains.
Une seule requête parfois suffit à déclencher une alerte chez Google.
Donc remplissez le recaptcha, prouvez que vous n’êtes pas un robot, et continuer.
Le dorking consiste à utiliser des commandes avancées de Google Search pour découvrir des fichiers accessibles via les moteurs de recherche qui sont censés être confidentiels. Cela sert pour faire de l’OSINT (pourquoi pas), mais aussi à des fins beaucoup plus malveillantes…
Donc tant que vous utilisez ces commandes sur votre site pour découvrir ce qui est indexé et ne devrait pas l’être, vous êtes tranquilles (y compris aux yeux de Google).
Et pourquoi pas inurl: ?
Parce que la commande me fonctionne plus correctement dans Google depuis huit mois maintenant et on ne sait pas vraiment pourquoi.
Avant, on aurait pu écrire la requête comme ceci :
site:[votredomaine.com] -inurl:www Et cela marchait très bien aussi. Heureusement, la syntaxe indiquée plus haut fonctionne, elle !
Mais c’est bien dommage, car « inurl: » avait un grand intérêt pour trouver facilement certaines urls.
Google, rends-nous « inurl: » s’il te plait
Pour en savoir plus
- Affiner les recherches Google : https://support.google.com/websearch/answer/2466433
- Bing : advanced search options : https://support.microsoft.com/en-us/bing/advanced-search-options