Le 27 juillet 2026, le consultant SEO indépendant Javier Lorente Murillo a publié sur LinkedIn une question technique adressée à l’équipe Search de Google, en taguant John Mueller, Gary Illyes et Martin Splitt.
Son client gère un site d’annonces qui maintient environ 5 000 URL indexées stables et publie autour de 10 000 nouvelles annonces par mois, avec une durée de vie de 24 à 72 heures. Il veut utiliser la balise unavailable_after sur ces annonces éphémères pour éviter les 404 en masse et économiser du budget de crawl.
Problème : les annonceurs peuvent prolonger leur annonce, ce qui obligerait le site à repousser la date d’expiration à la volée.
Gary Illyes, analyste chez Google, répond d’abord qu’il n’en sait rien et qu’il doit vérifier. Puis il livre une intuition : repousser la date lui semble acceptable, mais Google devra recrawler la page pour voir la nouvelle date.
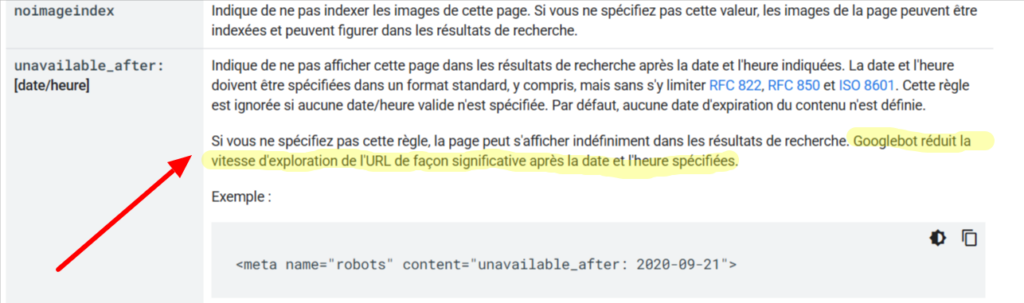
Sauf que la page de référence de Google sur les balises meta robots, mise à jour le 24 mars 2026, contient une phrase qui rend cette intuition problématique. Elle précise que si vous avez utilisé la valeur d’attribut « unavailable_after » Googlebot réduit considérablement la fréquence de crawl d’une URL après la date et l’heure indiquées. Donc certes on peut repousser la date de validité et la valeur de « unavailable_after », mais cela ne sert à rien car la nouvelle date risque fort de ne pas être découverte par Google à temps pour que cela serve à quelque chose.
Conclusion : sur un inventaire qui connait beaucoup de changements, unavailable_after est structurellement inutilisable, et Google recommande par ailleurs, noir sur blanc, un autre outil pour ce cas précis.
La question qui n’avait jamais été posée en public
unavailable_after n’est pas une nouveauté. Google la prend en charge depuis juillet 2007, soit dix-neuf ans.
Sa fonction est décrite en une ligne dans la page de référence sur les balises meta robots : ne pas afficher la page dans les résultats de recherche après la date et l’heure spécifiées.
Voici la syntaxe en html :
<meta name="robots" content="unavailable_after: 2026-10-15T23:59:59+02:00">et la version « en-tête http »
X-Robots-Tag: unavailable_after: 2026-10-15T23:59:59+02:00A quoi cela sert : à piloter des cas d’expiration bien définis :
- Une offre d’emploi avec date de clôture légale.
- Une page d’événement.
- Un jeu-concours.
- Une promotion bornée dans le temps.
Dans tous ces cas, cette date d’expiration est connue au moment de la publication et ne bouge plus.
Le cas soumis par Lorente Murillo est différent, et c’est ce qui le rend intéressant.
Sa formulation est précise : le système pousserait dynamiquement la date d’expiration plus loin dans le futur, à la volée. Sa question portait sur le risque que Googlebot finisse par se méfier d’une date qui glisse en permanence sur la même URL, voire par ignorer la balise.
Ce n’est pas une hypothèse d’école. Les sites d’annonces, les job boards, la billetterie, les plateformes d’enchères, la disponibilité hôtelière et les catalogues à rotation rapide produisent tous des URL dont la durée de vie utile se compte en heures ou en jours, avec un mécanisme de prolongation contrôlé par un tiers.
Le problème en détails
Le tableau des règles valides publié par Google décrit unavailable_after en deux temps.
D’abord la fonction : la page n’est plus affichée après la date.
Ensuite une conséquence que presque personne ne relève, et que la couverture anglophone du fil a intégralement manquée : après la date et l’heure spécifiées, Googlebot diminue fortement la fréquence de crawl de l’URL.
Reprenons le cas d’annonces avec cette phrase en tête.
Une annonce est publiée le lundi avec une date d’expiration au jeudi. Googlebot passe le mardi, lit la balise, enregistre jeudi. L’annonceur prolonge le mercredi, le site réécrit la date au dimanche. Pour que Google en prenne connaissance, il faut un passage entre mercredi et jeudi. S’il n’a pas lieu, Google retire l’annonce des résultats le jeudi. Et à partir de ce moment, il crawle cette URL beaucoup moins souvent.
L’annonce est en ligne, active, payée, et invisible. La correction remonterait au prochain passage de Googlebot, dont la fréquence vient précisément d’être abaissée par la directive elle-même.
Un site qui applique la balise sur de l’inventaire renouvelable ne pilote donc pas son cycle de vie. Il installe un mécanisme dont les erreurs se réparent d’autant plus lentement qu’elles viennent de se produire.
Erreur de catégorie : le crawl n’est pas l’affichage
L’objectif affiché par Lorente Murillo était double : éviter les 404 et maîtriser le budget de crawl (l’ensemble des URL que Google peut et veut explorer sur un hôte donné). La balise ne répond ni à l’un ni à l’autre.
Illyes le dit dans sa réponse : la directive n’a d’implication que sur la sélection d’index (l’étape où Google décide quelles pages crawlées méritent d’entrer dans l’index et d’être servies).
Elle agit comme un signal autorisant l’abandon de l’URL. Elle ne dit rien sur la fréquence de crawl avant la date, ni sur le code HTTP renvoyé par le serveur, ni sur les liens externes qui pointent vers l’annonce morte.
Google explicite d’ailleurs ce raisonnement, mais pour une autre directive. La page sur le budget de crawl, dans sa version du 22 juillet 2026, déconseille frontalement le noindex comme levier d’économie : Google requête quand même la page, puis la laisse tomber en voyant la balise, ce qui gaspille du temps de crawl.
Le mécanisme est identique pour unavailable_after. La balise vit dans la page. Pour la lire, il faut télécharger la page. Aucune économie de crawl ne peut sortir d’un signal qui n’existe qu’à l’intérieur du contenu qu’on cherche à ne plus télécharger.
Google écrit la mise en garde pour noindex. Il ne l’écrit pas pour unavailable_after. Le raisonnement vaut pourtant à l’identique.
Ce que Google recommande vraiment pour ce cas
Certains sont tentés de passer par des redirections conditionnelles (redirections 304), ou de renvoyer un x-robots-tag avec un attribut unavailable_after en espérant que cela sera renvoyé par des requêtes HEAD. Google a bien précisé que cela ne marcherait pas.
La recommandation officielle pour ce cas d’usage est ailleurs, et elle est explicite. La page sur le budget de crawl demande de renvoyer un 404 ou un 410 pour les pages définitivement supprimées, en précisant que le 404 constitue un signal fort de ne pas recrawler l’URL.
Autrement dit : le mécanisme que Lorente Murillo cherchait à éviter est celui que Google recommande.
Mais on touche ici tout bonnement aux limites de ce que Google permet comme paramétrage du crawl !
Pourquoi ça compte, et ce que vous devez faire
Le risque n’est pas théorique. Si vous exploitez de l’inventaire renouvelable et que vous posez unavailable_after sur la durée nominale, vous fabriquez des retraits d’annonces actives dont la réparation dépend d’un crawl que la directive vient de ralentir. Sur un site qui publie 10 000 annonces par mois, une désynchronisation même partielle porte sur des milliers d’URL, et elle frappe précisément l’inventaire que vos clients viennent de payer pour prolonger.
Cinq gestes, par ordre de priorité.
- Renoncez à
unavailable_aftercomme levier de budget de crawl. C’est une directive d’affichage, pas d’exploration. Le budget de crawl se pilote par l’architecture, le maillage interne, les codes de statut, la segmentation des sitemaps et lelastmod. - Réservez la balise à une expiration connue à l’avance et non reportable.
- Traitez l’expiration réelle par le code de statut. 410 pour ce qui est définitivement mort, 404 sinon, ou page d’archive avec alternatives quand l’arbitrage commercial le justifie.
- Servez toute directive d’indexation côté serveur. HTML initial ou en-tête
X-Robots-Tag, jamais par JavaScript. - Vérifiez le format de vos dates. Les formats RFC 822, RFC 850 et ISO 8601 sont acceptés, et la règle est purement ignorée si aucune date valide n’est reconnue. Une directive silencieusement ignorée est le pire des scénarios : vous croyez piloter, vous ne pilotez rien.
Dernier rappel, valable pour toute la famille des règles meta robots : Google précise lui-même que les autres moteurs ne les traitent pas nécessairement de la même manière.
Bibliographie
- Robots meta tag, data-nosnippet, and X-Robots-Tag specifications, Google Search Central, mise à jour du 24 mars 2026
- Optimize your crawl budget, Google Crawling Infrastructure, mise à jour du 22 juillet 2026
- Google Crawler (User Agent) Overview, Google Crawling Infrastructure, section sur le cache HTTP
- Crawling December: HTTP caching, Gary Illyes, Google Search Central Blog
- The Problem With unavailable_after – Google Might Not See Updated Dates, Barry Schwartz, Search Engine Roundtable, 29 juillet 2026
- Google’s expiry tag forces a re-crawl, and it won’t fix 50% of 404 hits, Luis Rijo, PPC Land, 28 juillet 2026
- Google’s Illyes Unsure On Shifting unavailable_after Dates, Matt G. Southern, Search Engine Journal
- SEO et analyse de fréquence de crawl, Neper
- Optimisation du budget de crawl pour les grands sites, Neper
- Principes d’exploration et d’indexation de votre site par Google, Neper