John Mueller a commenté le 16 juillet dernier, dans un épisode de son podcast Search Off the Record intitulé « How to read the Indexing Report », le rapport Pages de la Google Search Console.
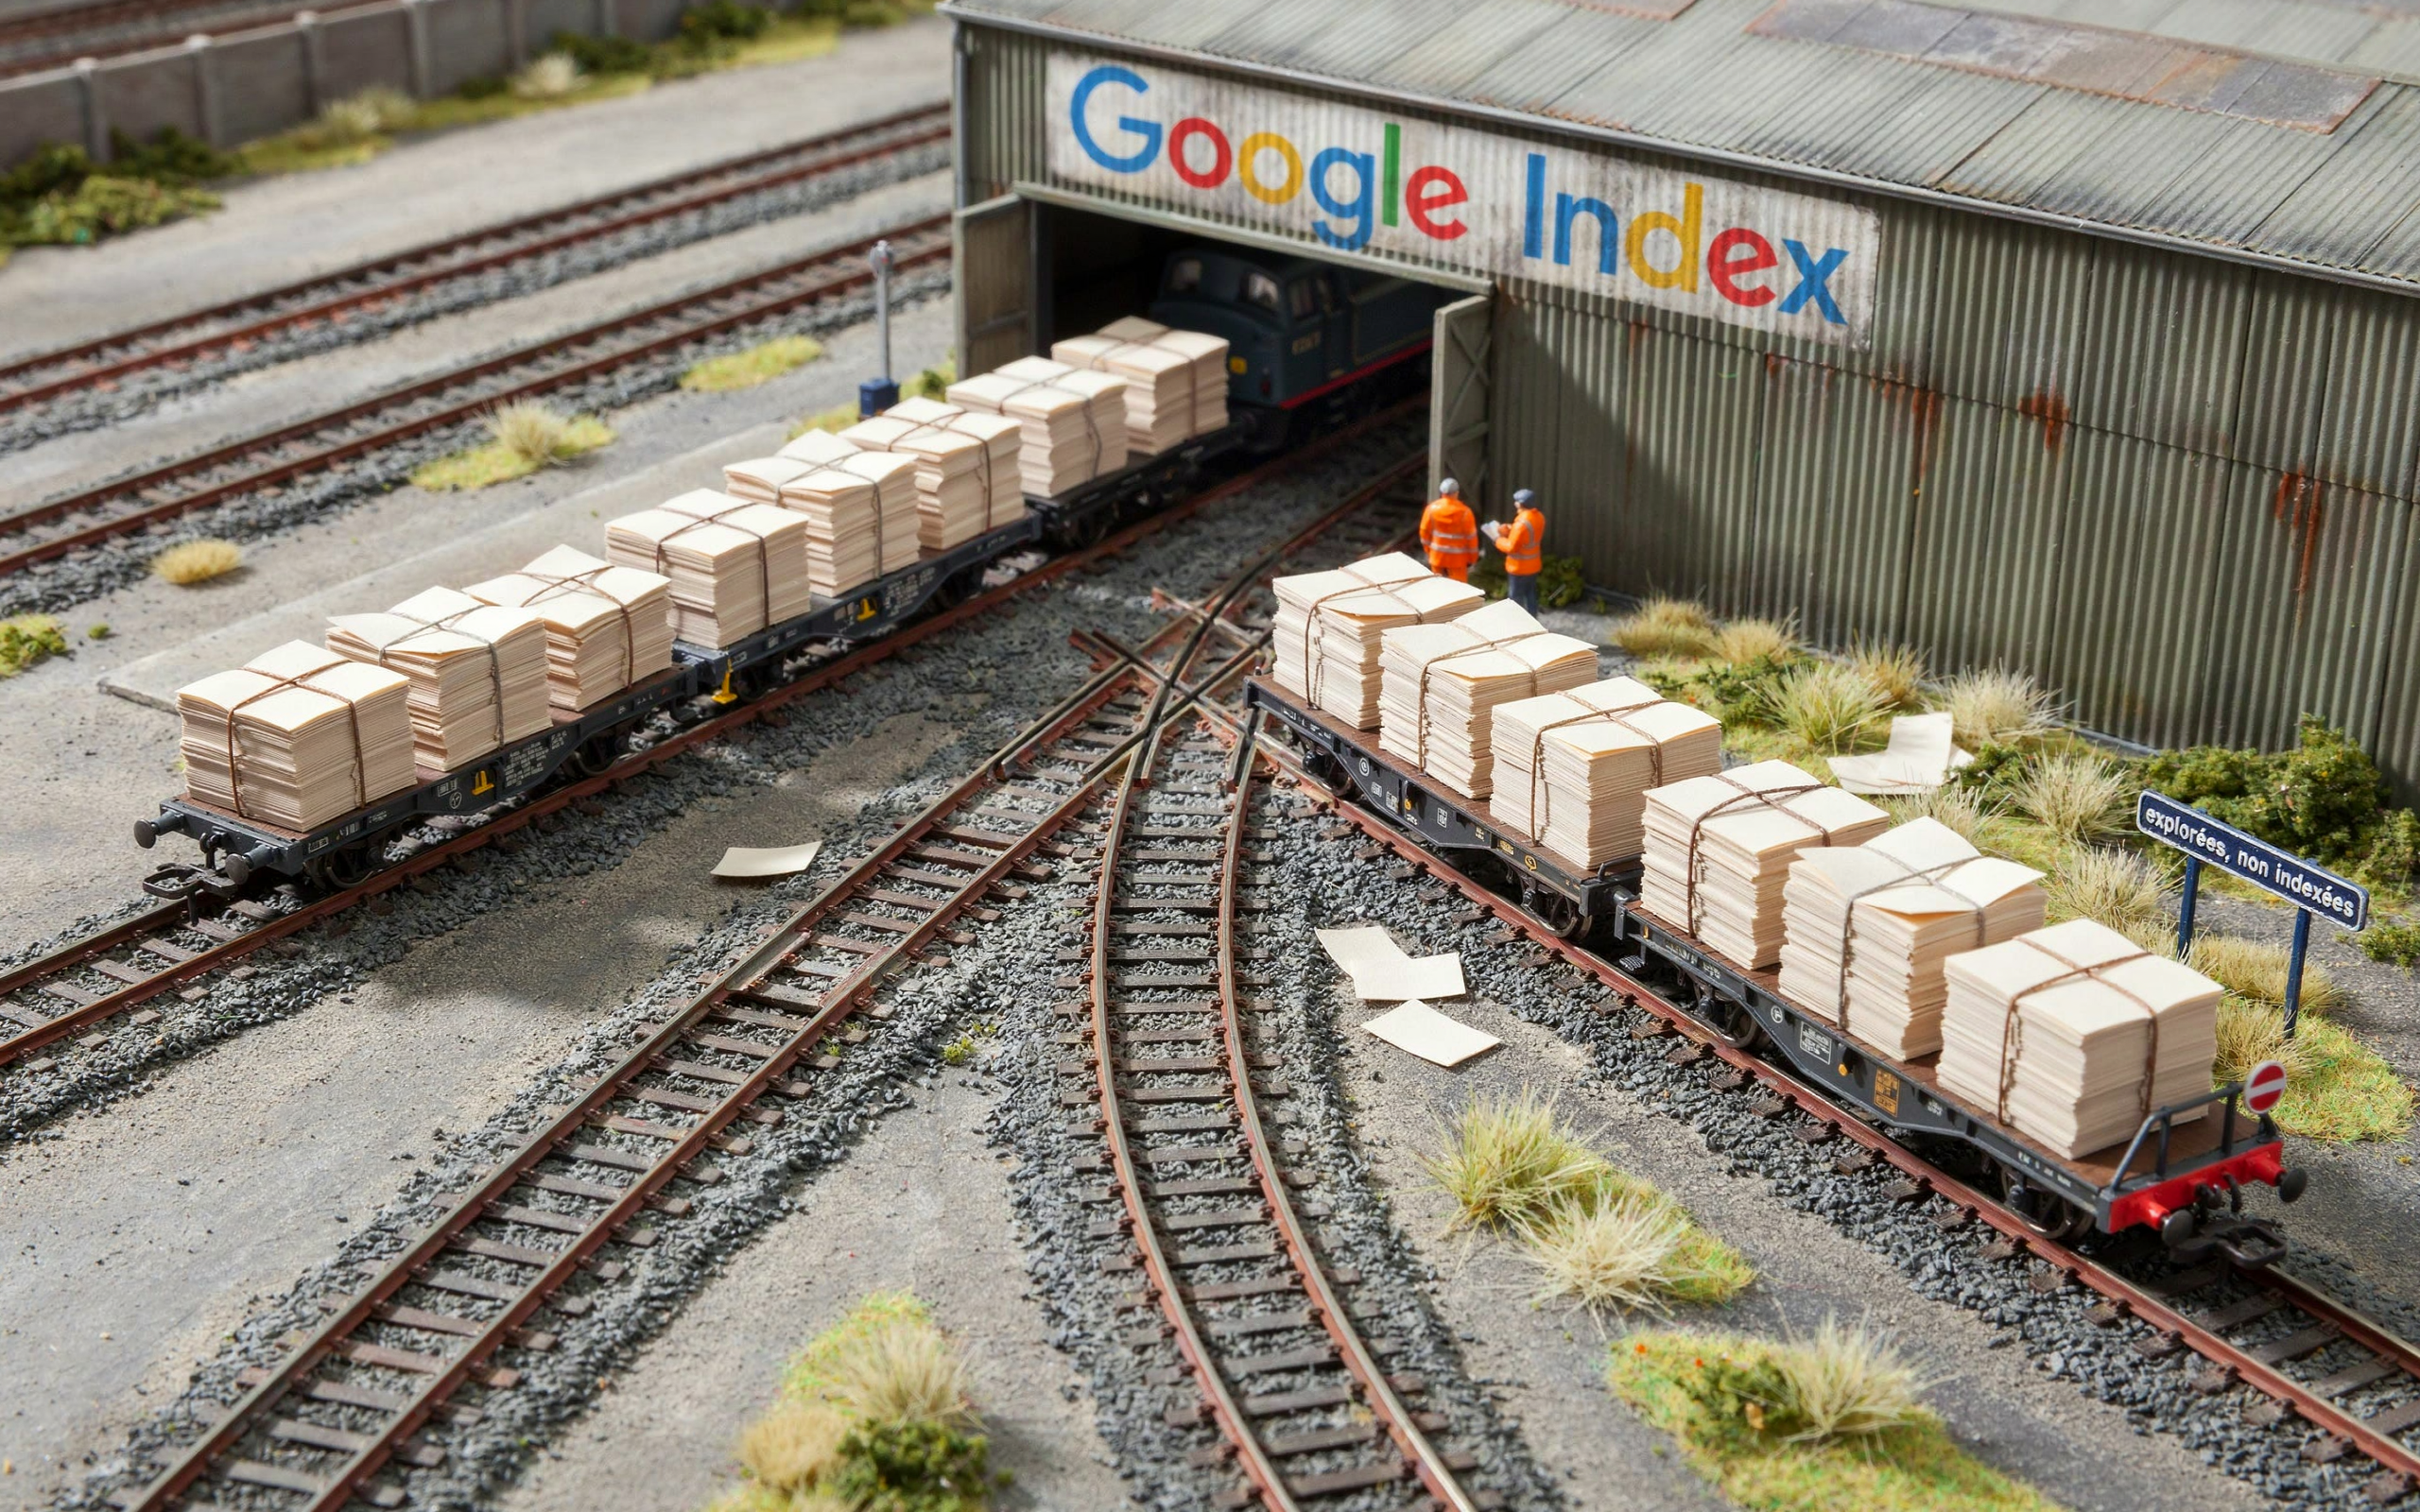
Et au passage, a fourni une confirmation à propos des causes du statut « Explorée, actuellement non indexée« . Les plus sagaces d’entre vous avaient deviné que les causes techniques souvent invoquées comme à l’origine de ce statut n’étaient pas les seules causes possibles.
Et bien, c’est confirmé.
Et cela explique pourquoi certains remèdes échouent le plus souvent à changer quoi que ce soit :
- La soumission d’un sitemap temporaire,
- La resoumission d’URL
- L’optimisation du maillage interne
- etc.
L’éditeur d’outil Indexing Insight mesure que sur 1,7 million de pages surveillées, 70 à 80 % des URL portant ce statut avaient déjà été indexées par le passé. Cela implique que dans l’immense majorité des cas, les urls rangées sous ce statut ne sont pas des pages en attente d’indexation.
Ce sont des pages retirées de l’index.
De là à dire qu’il faudrait renommer le statut « explorée, précédemment indexée » il n’y a qu’un pas. Mais ce ne serait pas exact : ce n’est pas vrai pour toutes les urls, et même, compte tenu de la variabilité des causes pour ce statut, de tout les sites. C’est juste un comportement ultra-répandu.
Deux statuts que tout oppose
La Search Console range sous deux libellés voisins deux étapes distinctes du traitement.
Détectée, actuellement non indexée signifie que Google connaît l’URL, par un lien ou par un sitemap, et ne l’a jamais visitée. Aucun jugement n’a été porté sur son contenu, pour la bonne raison que ce contenu n’a jamais été téléchargé. Les causes possibles sont la charge serveur, la profondeur de l’arborescence, la découvrabilité.
Explorée, actuellement non indexée signifie que Googlebot a récupéré la page, l’a analysée, et ne l’a pas retenue. La décision a été prise en connaissance de cause.
La fiche d’aide en français de Google reste très avare d’explications sur ce second cas. Elle indique que la page a été explorée sans être indexée, que ce statut pourra évoluer, et qu’il est inutile de resoumettre l’URL. C’est tout
Une partie du rapport relève par ailleurs du bruit normal et ne demande aucune action :
- les URL de flux du type
/feed/, - la pagination,
- les URL portant des paramètres de tri ou de filtre,
- les variantes non canoniques,
- etc.
Le compteur brut n’a donc aucune valeur de diagnostic tant qu’il n’a pas été filtré pour isoler les urls indexables, canoniques qui devraient être indexées et ne le sont pas.
Ce que Mueller a dit le 16 juillet, et ce qu’il n’a pas dit
Le passage commence à 20:32 de l’épisode. Martin Splitt demande à John Mueller si le statut signale souvent un problème de qualité, ou seulement parfois. La réponse commence par « parfois », et cette réserve n’est pas une figure de style.
Mueller décrit ensuite un mécanisme d’allocation de ressources. Quand les systèmes doutent sérieusement de la qualité d’ensemble d’un site, il devient inutile pour Google d’y consacrer du temps machine. L’exploration baisse, l’indexation baisse, et les deux statuts de non-indexation gonflent. Il ajoute que ces lignes ne sont pas un problème technique à corriger, et que face à un schéma répété sans cause technique, il faut examiner la qualité du site entier.
Est-ce que ce problème de qualité peut être causé par l’usage d’IA génératives ? Oui, car si la conclusion d’un lecteur lambda sur ce contenu c’est que n’importe qui aurait pu l’écrire ( « anyone could have written this »). Il précise dans la même réponse que tout contenu produit avec de l’IA n’est pas mauvais pour autant.
En clair, si ce contenu est de type « commodity content », cela va finir par poser problème.
Trois précisions importante qui ont été souvent oubliés dans les commentaires écrits sur ce podcast :
Ce problème de qualité est identifié au niveau du site, pas de la page : les URL listées ne sont pas individuellement condamnées, elles subissent une décision prise au-dessus d’elles. Il semble néanmoins que certains buckets d’urls, définis par le path soient en général plus ciblés et impactés que d’autres.
Mueller n’annonce par ailleurs aucun changement de comportement des systèmes, il explique un fonctionnement existant.
Mueller n’a pas parlé du phénomène d’urls avec ce statut indexées puis retirées de l’index.
Mais la consultante US Marie Haynes a assisté en avril 2026 à un événement Google Search Central à Toronto où les organisateurs interdisaient l’attribution nominative des propos tenus. Elle en rapporte qu’un intervenant a décrit un fonctionnement où Google indexe temporairement certaines pages pour observer si elles rendent les internautes plus satisfaits. Ce phénomène d’indexation/desindexation est observable depuis longtemps.
Les causes techniques existent, mais le problème peut être la qualité perçue par Google
Conclusion, ce statut peut avoir des causes :
- techniques, liées aux urls concernées
- ou un problème de qualité du contenu du site perçu par Google, qui décide ne pas indexer ce contenu
Avant toute lecture qualitative, une vérification s’impose, et Marie Haynes en donne le meilleur exemple.
Elle a examiné un site fraîchement migré dont l’intégralité des pages stagne dans le statut. Le test en direct de l’outil d’inspection d’URL affiche un titre, quelques mots de gabarit, et rien d’autre. La cause tient à une ligne du fichier robots.txt : Disallow: /*?*. La règle visait à écarter de l’exploration les URL portant des paramètres de suivi ou de commentaire. Le nouveau thème du site chargeait ses feuilles de style et ses scripts par des URL paramétrées.
Google, comme tous les autres robots, se voyait refuser les ressources nécessaires au rendu. Donc les pages étaient sans intérêt pour l’indexation.
Le contenu commodité
Haynes propose le terme le plus opérationnel du dossier : le contenu commodité, un contenu que presque n’importe qui pourrait produire sur un sujet, et qui reprend ce qui existe déjà ailleurs sans rien y ajouter. Son observation de terrain est plus inconfortable que le diagnostic habituel. Les pages qu’elle examine ne sont pas mauvaises. Ce sont de bons articles, aussi bons que ceux qui se classent.
C’est exactement le problème. Être aussi bon que l’existant ne justifie pas d’ajouter un exemplaire de plus à l’index.
Splitt : la qualité n’est pas dans le texte
Le point le plus directement applicable de l’épisode vient de Martin Splitt : il liste les problèmes qui peuvent rendre une page « de mauvaise qualité » aux yeux de Google, même si le contenu est Ok.
Un contenu réellement original peut être servi dans une page inutilisable.
Splitt énumère les cas :
- texte enfoui sous les publicités,
- masqué derrière des interstitiels,
- noyé au milieu d’éléments qui apparaissent et disparaissent,
- ou repoussé loin du premier écran après un long remplissage. Son exemple est la recette de cuisine précédée d’un récit personnel interminable. Il ajoute l’image du ventilateur d’ordinateur qui s’emballe au chargement.
Sa justification est logique. L’internaute ne dispose d’aucun mode qui extrairait le contenu principal d’une page. Il subit l’expérience complète, publicités comprises. L’évaluation doit donc porter sur cette expérience complète, pas sur le seul bloc de texte que l’éditeur considère comme son contenu utile.
Pourquoi ça compte, et ce que vous devez faire
Cette confirmation doit vous inciter à mieux diagnostiquer les causes de présence d’un grand nombre d’urls avec le statut « Explorée, non indexée ».
Filtrez, puis essayer d’établir des volumétries pour chaque pattern / cas. Exportez la liste, écartez les flux, la pagination, les URL paramétrées et les variantes non canoniques. Ne gardez que les URL dont vous voulez réellement l’indexation. Tout diagnostic posé sur le compteur brut est faux.
Lancez le test en direct sur un échantillon. Vérifiez dans l’outil d’inspection que Googlebot restitue le contenu principal après rendu. Un rendu vide oriente vers un blocage de ressources ou un problème de rendu JavaScript, et cette piste se traite en quelques heures.
Segmentez par gabarit et par rubrique. Croisez les URL retenues avec les modèles de page et l’arborescence. Une rubrique entière touchée pendant que le reste du site tient est un signal intéressant.
Auditez l’expérience de page avant de réécrire le texte. L’expérience utilisateur et l’expérience de recherche sont importantes et prises en compte indirectement par l’algorithme.
Et si le problème c’est la qualité de votre contenu ou le « commodity content » => là, il faudra revoir votre stratégie de contenu, ce qui n’est jamais simple/
Bibliographie
- Why your pages are stuck in crawled-currently not indexed. And what to do about it., Marie Haynes, 16 juillet 2026 (source primaire)
- Search Off the Record, How to read the Indexing Report, Google Search Central, 16 juillet 2026 (source primaire)
- Creating helpful, reliable, people-first content, Google Search Central (source primaire)
- Google: Discovered vs Crawled Not Indexed Quality Issues & AI-Generated Content, Barry Schwartz, Search Engine Roundtable, 16 juillet 2026
- Google buries good pages as commodity content loses index spot, Haynes finds, Luis Rijo, PPC Land, 18 juillet 2026
- 5 Hidden Insights in the Page Indexing Report, Indexing Insight